GPT-6 Astra, lanzado el 3 de septiembre de 2026, aporta ganancias relevantes en tareas de código agéntico. Alcanza a los modelos más fuertes del mercado por menos de la mitad del costo. En la inteligencia general, el menor uso de tokens queda compensado por un precio más alto.
Por qué esto importa para quien usa Tess
Tess reúne varios modelos de IA en un solo workspace. Elegir el modelo adecuado para cada tarea cambia la calidad del resultado y el costo. GPT-6 Astra es el nuevo modelo de razonamiento de OpenAI y el sucesor de GPT-5.6 Sol. Los resultados independientes de Artificial Analysis muestran dónde es una buena elección y dónde el cambio todavía puede no compensar en lo financiero.
Precio: bastante más alto
GPT-6 Astra cuesta 2,5 veces las tarifas de GPT-5.6 Sol: de US$ 4 / US$ 20 a US$ 10 / US$ 50 por millón de tokens de entrada / salida. Mantiene el descuento del 90% en la lectura de caché y el recargo del 25% en la escritura de caché.
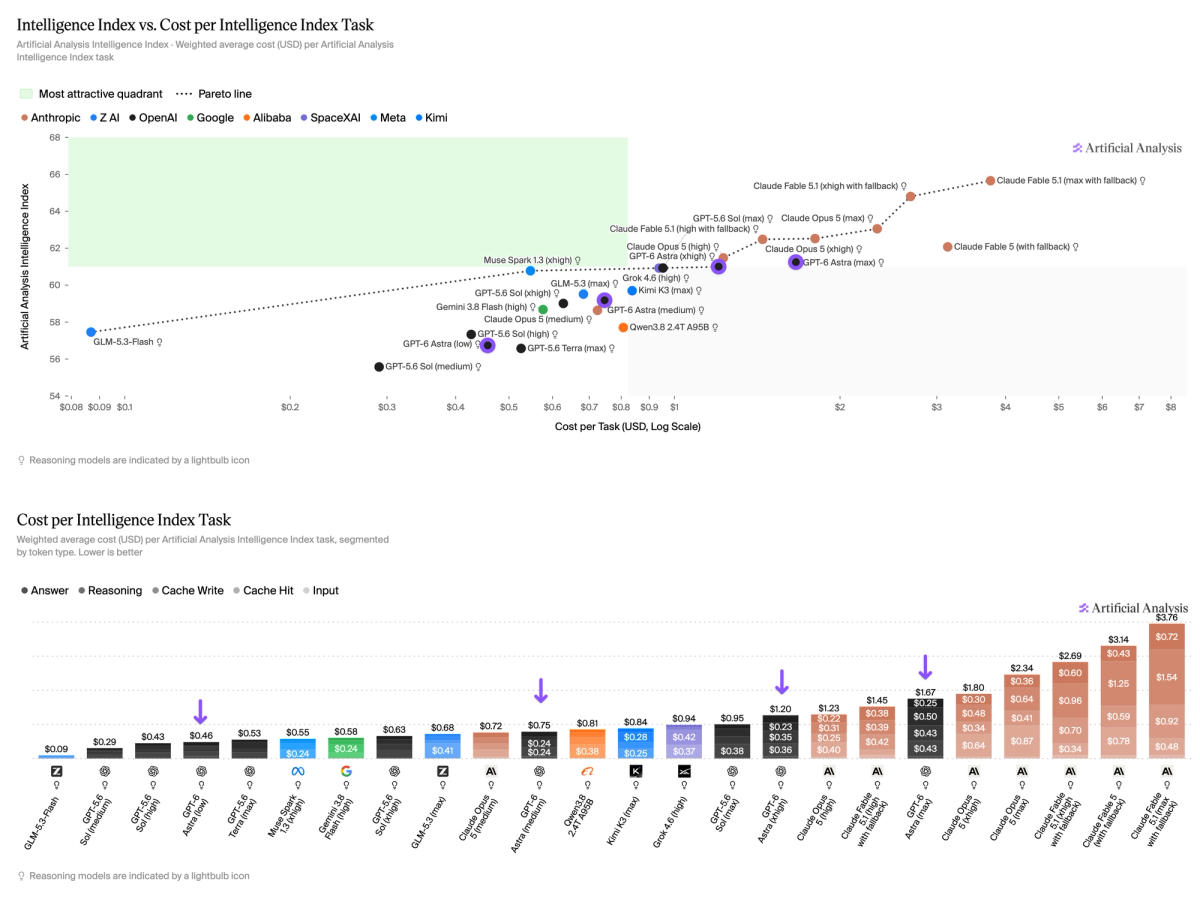
En resumen: hay dos historias. En el Coding Agent Index, Astra empata con los modelos líderes por menos de la mitad del costo. En el Intelligence Index, es más eficiente en tokens que su predecesor, pero el aumento de precio borra esa ventaja.
Aspectos destacados del Coding Agent Index
➤ Compite con los líderes del mercado
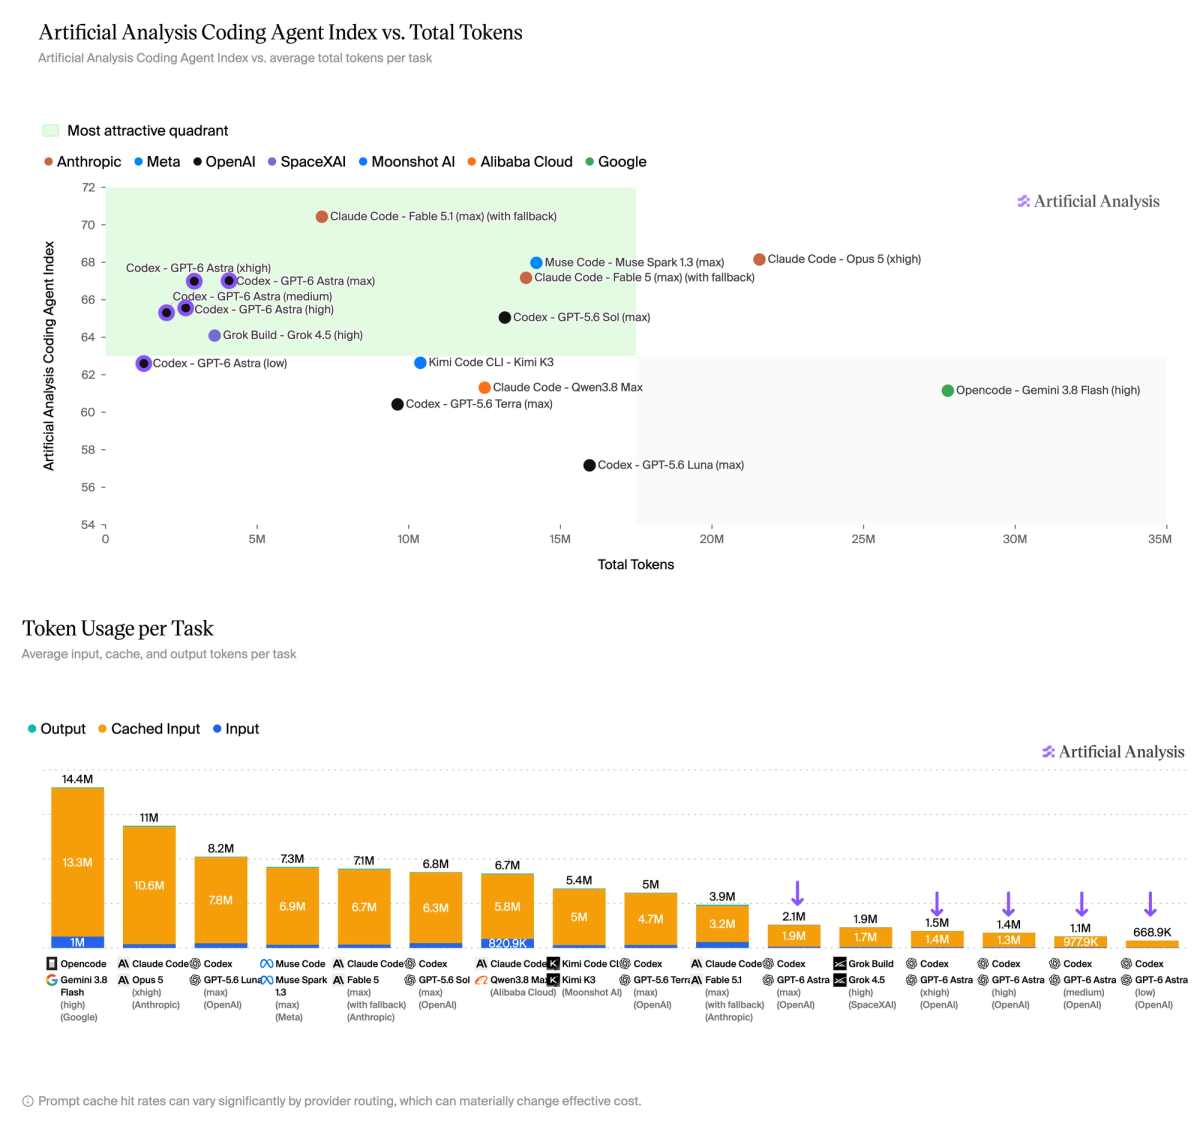
En Codex, GPT-6 Astra marca 67 en el índice, cerca de Claude Opus 5 y de Fable 5 en Claude Code, y de Muse Spark 1.3 en Muse Code. Fable 5.1 en Claude Code lidera el índice con 70.
➤ Un 70% más eficiente en tokens que GPT-5.6 Sol
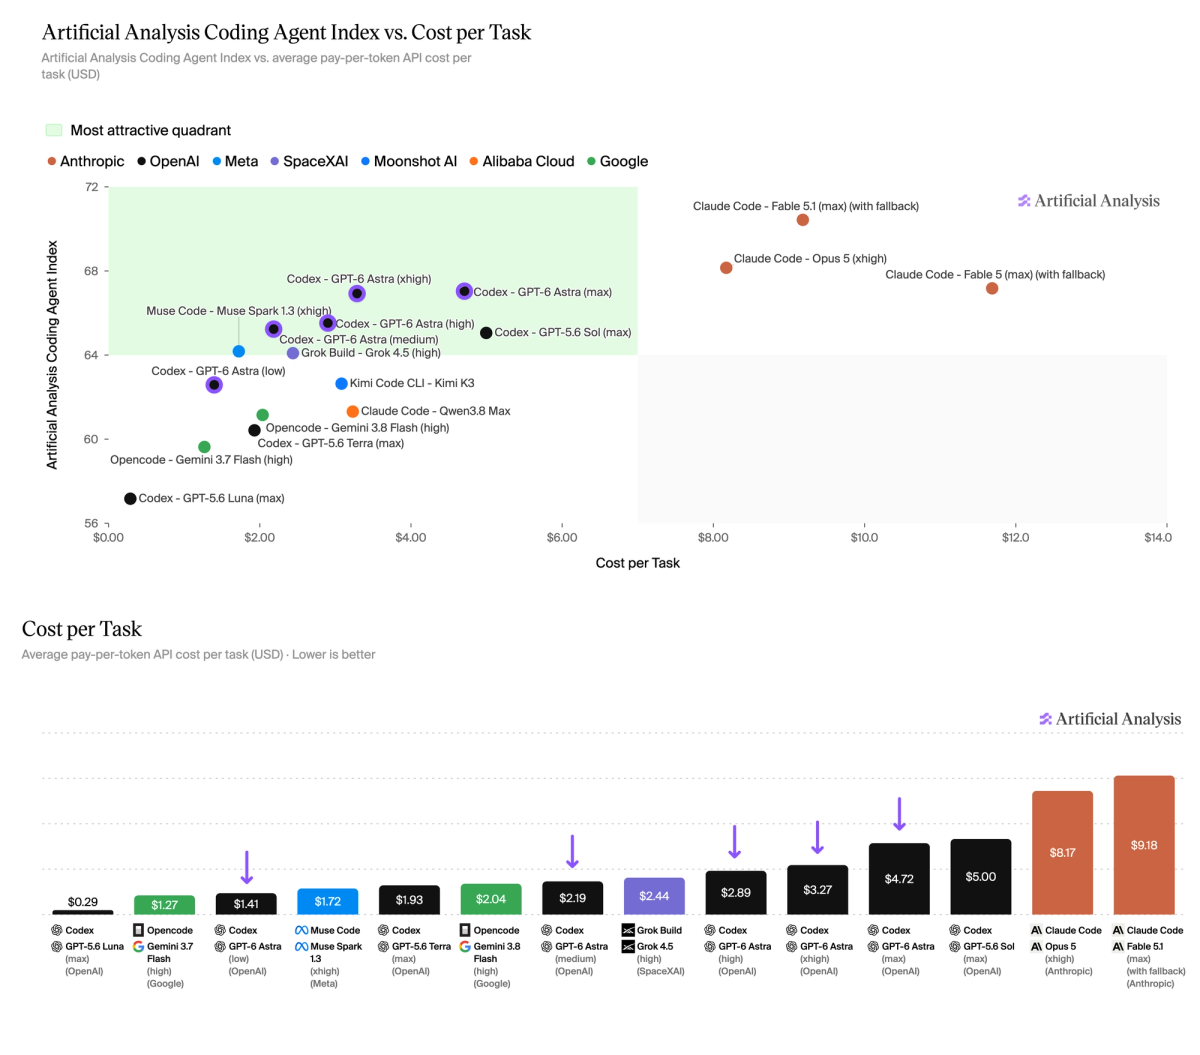
Astra usa un tercio de los tokens que consume GPT-5.6 Sol (esfuerzo máximo) en el harness de Codex, y un quinto de los tokens que usa Claude Opus 5 (xhigh). Sus niveles de esfuerzo ocupan la frontera de Pareto de la eficiencia en tokens.
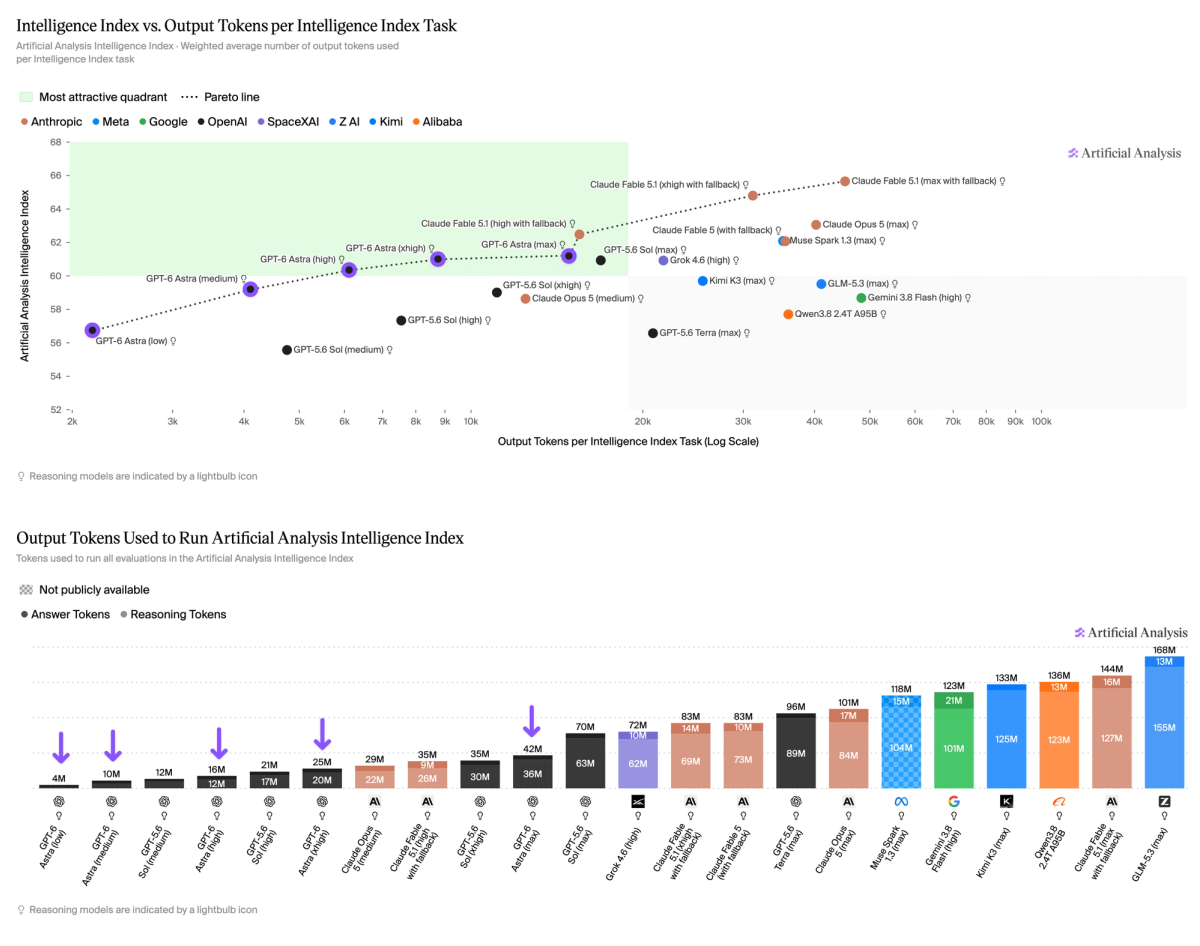
➤ Lidera la frontera de costo-eficiencia en código
En el esfuerzo máximo, GPT-6 Astra cuesta casi lo mismo que GPT-5.6 Sol (max) y marca dos puntos más. Por tarea, cuesta menos de la mitad que Claude Fable 5 para la misma nota.
Fuente: Artificial Analysis — Coding Agent Index
La mejora de costo en código viene sobre todo de la eficiencia en tokens: en el esfuerzo máximo, Astra reduce el uso de tokens unas 3 veces respecto de GPT-5.6 Sol (max).
Fuente: Artificial Analysis — eficiencia de tokens en el Coding Agent Index
Fuente: Artificial Analysis — Coding Agent Index frente al costo por tarea
Aspectos destacados del Intelligence Index
➤ Empata con GPT-5.6 Sol en inteligencia general
GPT-6 Astra empata con GPT-5.6 Sol en 61 en el índice. Son cinco puntos por debajo de Claude Fable 5.1 (max con fallback) y también detrás de Muse Spark 1.3 (max), de Meta.
➤ Cerca de un 10% menos de tokens de salida, a un precio más alto
En el esfuerzo máximo, Astra usa cerca de un 10% menos de tokens de salida que GPT-5.6 Sol y abre una nueva frontera de eficiencia entre inteligencia y tokens de salida por tarea. El precio 2,5 veces mayor hace que cada tarea cueste un 75% más que la de su predecesor.
➤ Reduce las alucinaciones cerca de a la mitad
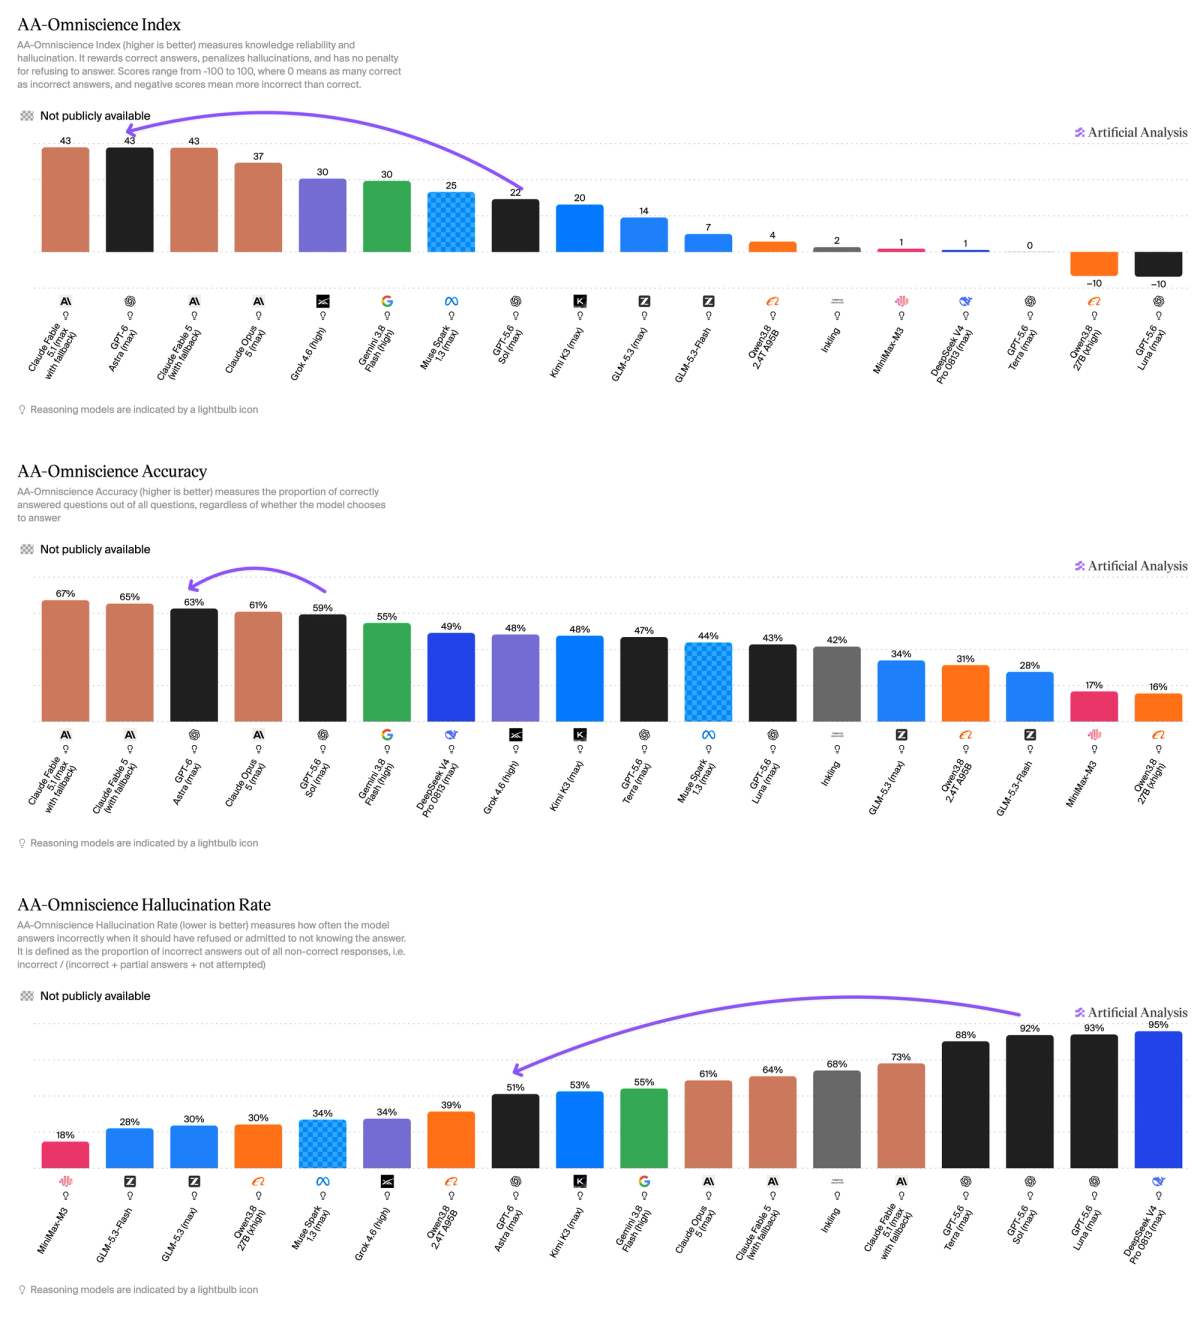
En AA-Omniscience, el benchmark de conocimiento y alucinación de Artificial Analysis, la tasa de alucinación baja del 92% al 51% en el esfuerzo máximo. A diferencia de algunos modelos, esa ganancia no sale de la exactitud: la exactitud de Astra también sube cuatro puntos.
➤ Gana unos 80 puntos de Elo en AA-Briefcase
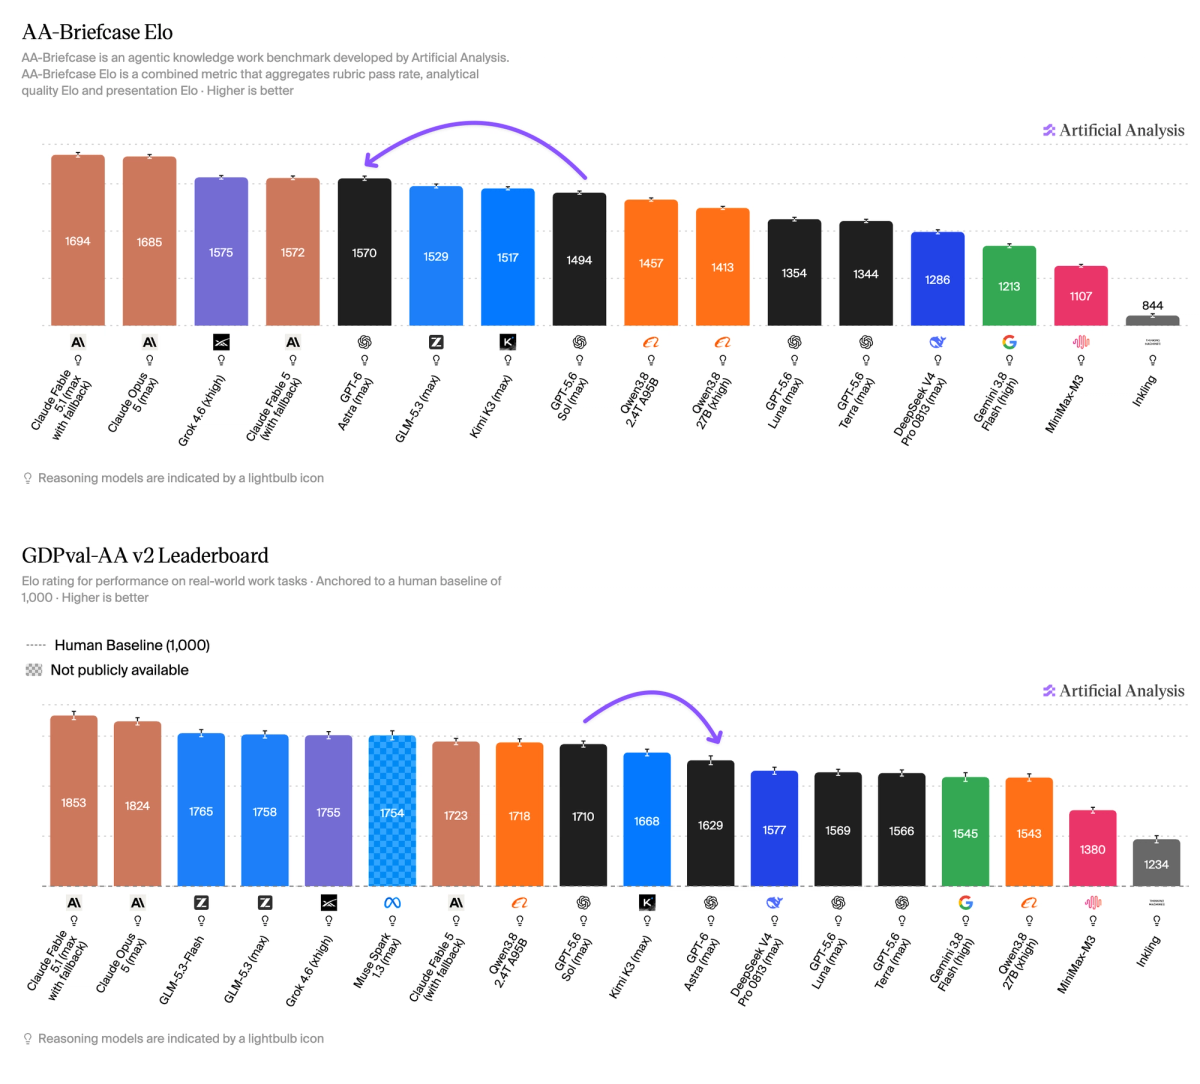
GPT-6 Astra sube unos 80 puntos en AA-Briefcase, una evaluación de trabajo de conocimiento de largo horizonte que prueba proyectos de varias semanas, con tareas encadenadas y miles de archivos de origen. Mejora las notas de rúbrica y el Elo de calidad analítica, mientras el Elo de calidad de presentación baja. GPT-5.6 Sol (max) sigue liderando en calidad de presentación.
➤ Avance mixto en las demás evaluaciones
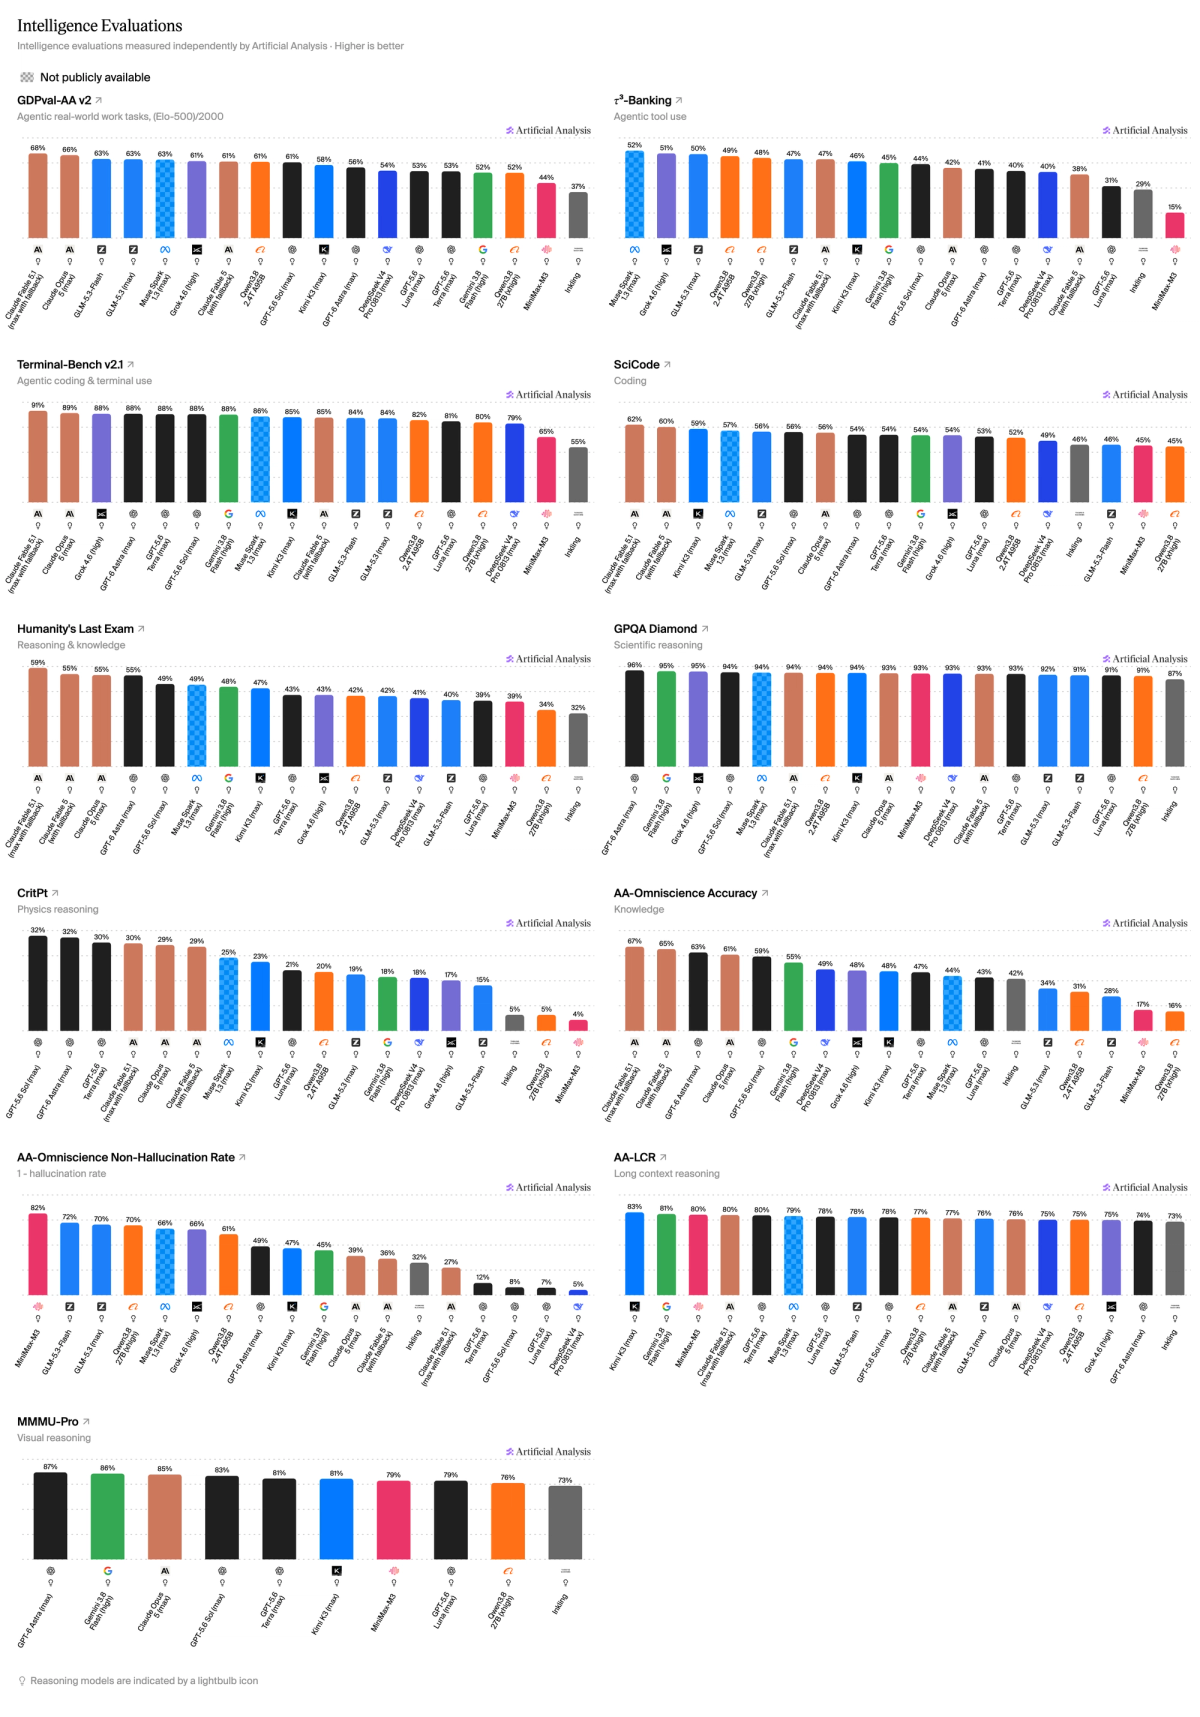
El modelo gana seis puntos en Humanity's Last Exam y pierde unos 80 puntos de Elo en GDPval-AA v2, que mide tareas de valor económico en 44 ocupaciones. Artificial Analysis también encontró regresiones de 2 a 3 puntos en τ³-Banking, SciCode y AA-LCR.
Fuente: Artificial Analysis — Intelligence Index frente a tokens de salida por tarea
Fuente: Artificial Analysis — Intelligence Index frente al costo por tarea
Fuente: Artificial Analysis — AA-Omniscience (conocimiento y alucinación)
Fuente: Artificial Analysis — AA-Briefcase y GDPval-AA v2
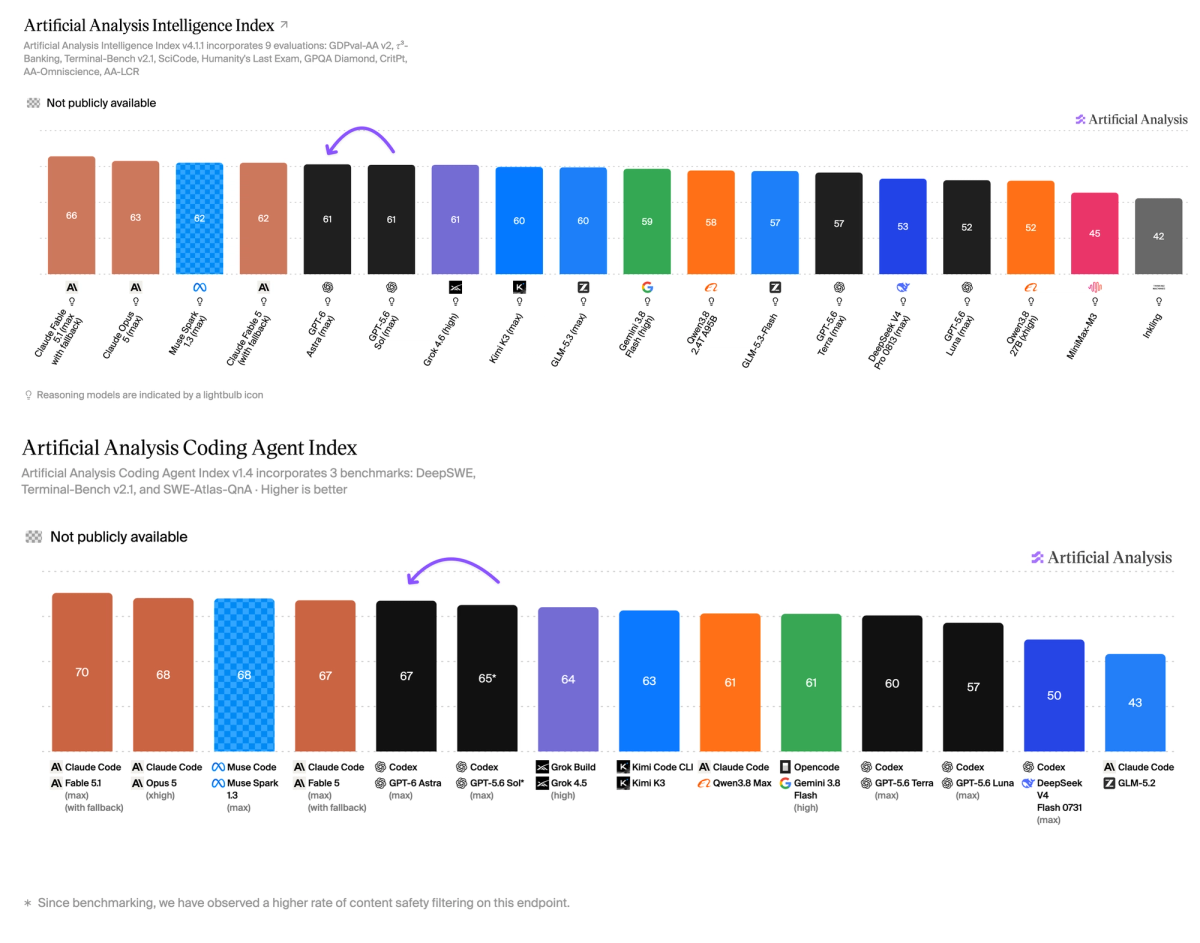
Fuente: Artificial Analysis — desglose de las evaluaciones del Intelligence Index v4.1.1
En la práctica
- Para código y tareas agénticas: GPT-6 Astra es una buena opción. Entrega un desempeño al nivel de los modelos líderes del mercado por una fracción del costo de la alternativa más cara.
- Para razonamiento e inteligencia general: el menor uso de tokens no compensa el aumento de precio. Compara las alternativas antes de migrar.
- Para tareas sensibles a los hechos: la caída de las alucinaciones es una de las ganancias más importantes de Astra, y los resultados siguen pidiendo revisión.
- Para proyectos largos y complejos: la calidad analítica mejora de forma clara, y la calidad de presentación puede pedir una edición más.
La mejor forma de elegir un modelo es probarlo en tu propio flujo. Tess hace posible esa comparación al dar al equipo acceso a varios modelos de IA en un solo workspace.
Datos, gráficos y metodología originales: Artificial Analysis — “Benchmarking GPT-6 Astra”, publicado el 3 de septiembre de 2026.