Grok 4.7, lanzado el 21 de septiembre de 2026, no se queda con el Intelligence Index. Hace algo más útil para un equipo que ya tiene un modelo de frontera en el workspace: se acerca en el trabajo que los agentes de verdad hacen, al precio de Grok 4.6. La factura cambia igual, porque el modelo gasta muchos más tokens para llegar ahí.
Por qué esto importa para quien usa Tess
Un texto de benchmark es fácil de leer como ranking. La decisión en Tess es más estrecha. Astra, Fable, Sol y Grok ya pueden estar en el mismo workspace, en el mismo agente, sobre los mismos documentos. Grok 4.7 gana un lugar cuando la tarea es larga, el resultado es un análisis o un cambio de código, y una persona revisa lo que sale. Es un valor predeterminado débil cuando alguien espera una respuesta corta en el chat, o cuando la última milla es una presentación que el cliente va a ver sin retoque.
Artificial Analysis midió el modelo en el esfuerzo xhigh. La tabla de lanzamiento de xAI es un segundo retrato, de harnesses distintos. Léelos juntos. No saques el promedio.
Precio: la tabla no se movió, la tarea sí
El precio de lista sigue el de Grok 4.6: US$ 2 por millón de tokens de entrada y US$ 6 por millón de tokens de salida. La lectura de caché sigue en US$ 0,50 por millón, un descuento del 75%. xAI también vende una variante rápida, con el doble de velocidad de salida y el doble de precio.
Esa etiqueta es el número equivocado para presupuestar. En el Intelligence Index, Grok 4.7 (xhigh) usa unos 81.000 tokens de salida por tarea, frente a unos 38.000 de Grok 4.6 (xhigh). A US$ 6 por millón, solo la salida pasa de unos US$ 0,23 por tarea a unos US$ 0,49. El mismo contrato, cerca del doble de la factura de salida, antes de entrada, caché, herramientas y reintentos.
Pon eso al lado de GPT-6 Astra. La tarifa publicada de salida de Astra es US$ 50 por millón, y Artificial Analysis lo midió en unos 27.000 tokens de salida por tarea de inteligencia, o unos US$ 1,35 de salida. Grok usa cerca de tres veces los tokens y aun así queda cerca de un tercio de la factura de salida de Astra, porque el precio por token es mucho más bajo. La diferencia de tokens se come parte del descuento. Una parte grande permanece.
La página del modelo pone el costo completo de una tarea del Intelligence Index en US$ 3,74, con entrada y caché incluidos. Ejecutar el índice entero costó US$ 4.967, sobre 240 millones de tokens de salida. Los modelos verbosos se vuelven caros en volumen aunque la tabla de precios parezca amable.
En resumen: frente a Grok 4.6, pagas más por tarea por una ganancia pequeña de inteligencia y una ganancia real en el trabajo de agente. Frente a los modelos de frontera a US$ 10 / US$ 50, Grok 4.7 sigue siendo el camino más barato para acercarse, y no es el camino para superarlos.
Aspectos destacados del Coding Agent Index
➤ Lo bastante cerca para que el precio empiece a importar
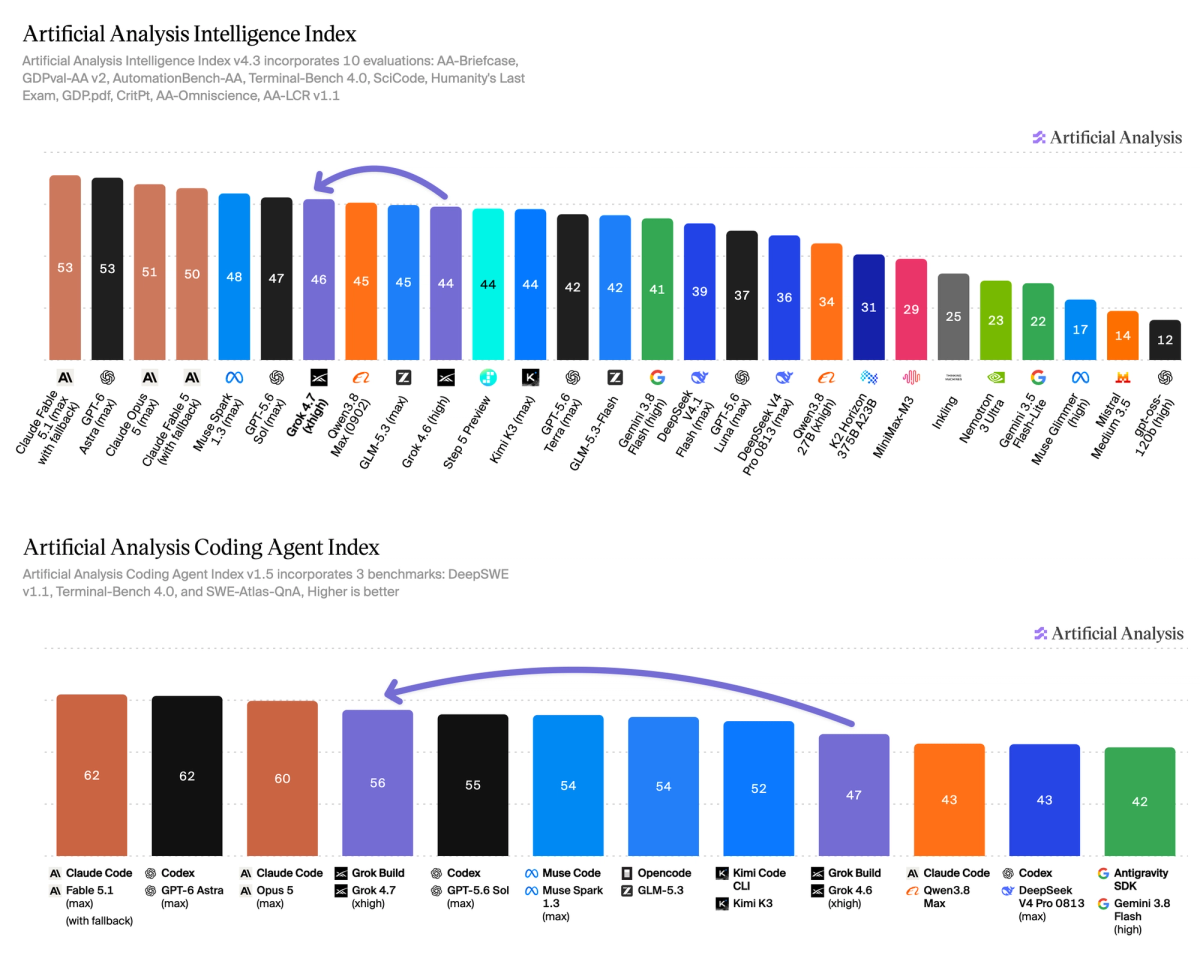
Con Grok Build, Grok 4.7 (xhigh) marca 56 en el Coding Agent Index, por encima de 47 de Grok 4.6 (xhigh). Queda cuarto entre los modelos en sus propios harnesses. Claude Fable 5.1 y GPT-6 Astra lideran con 62. Claude Opus 5 queda en 60. GPT-5.6 Sol (max), en Codex, queda en 55.
Seis puntos detrás de los líderes es una distancia real. No es otro deporte. Para un equipo que ejecuta muchas tareas de agente al día, esos seis puntos tienen que valer la tarifa de US$ 10 / US$ 50 de Fable frente a los US$ 2 / US$ 6 de Grok. En volumen, muchas veces no la valen. El índice es motivo para pilotar Grok. No es motivo para retirar el modelo en el que ya confías en los repositorios más difíciles.
➤ El promedio esconde el trabajo en el que va mal
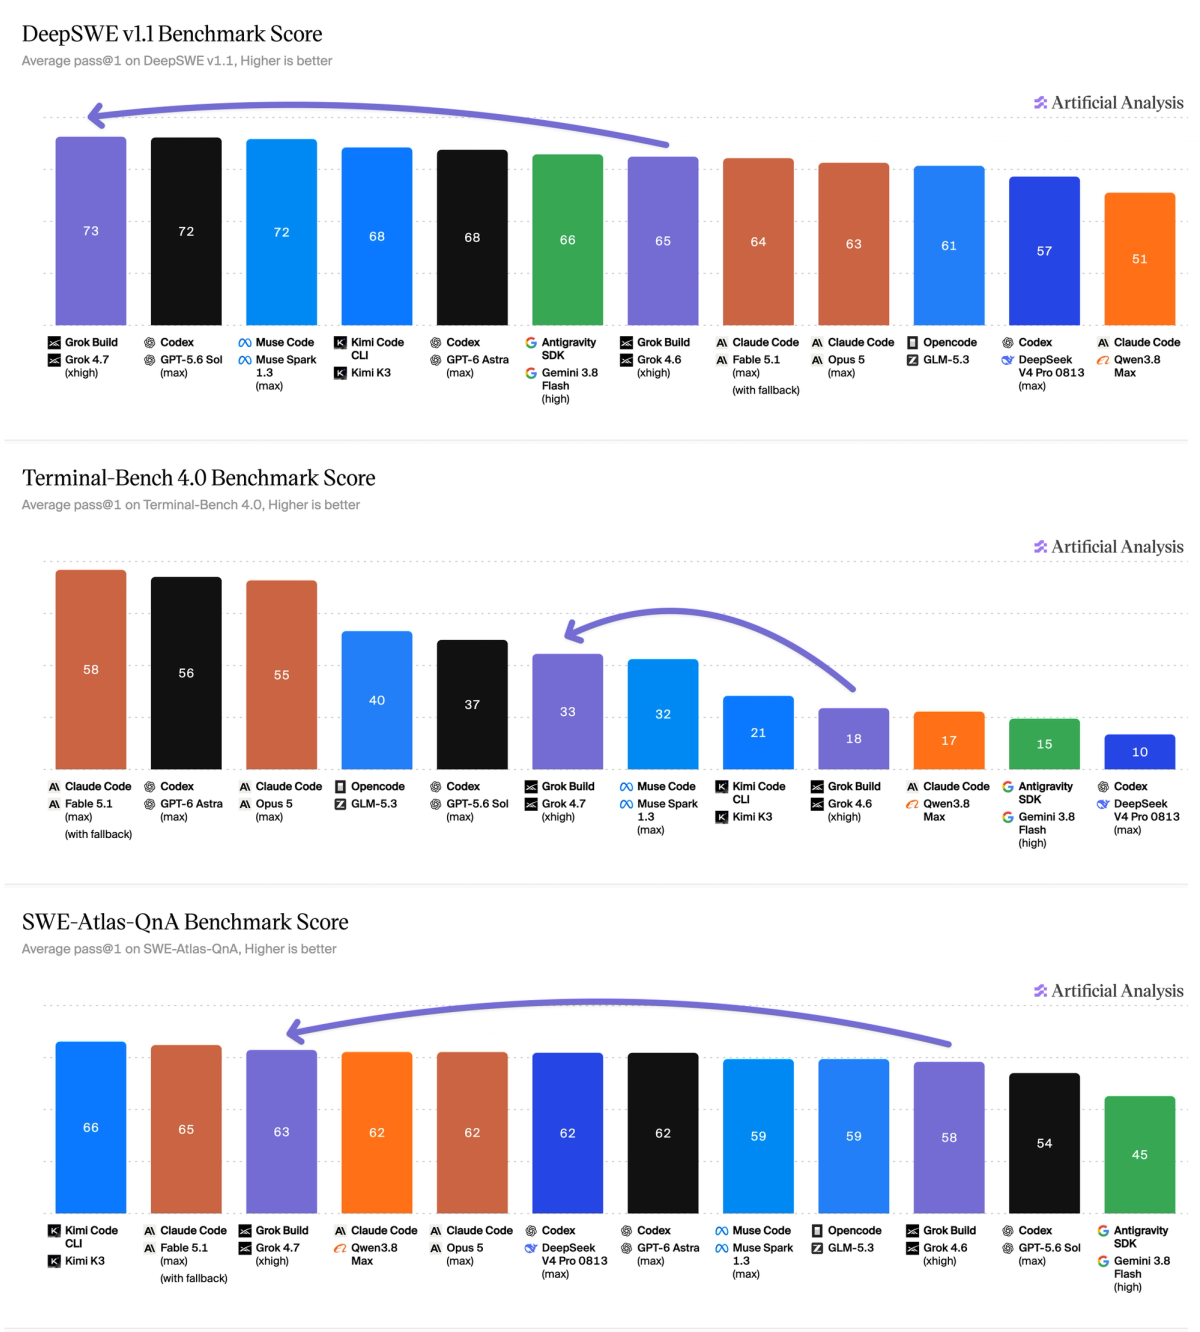
El salto de nueve puntos se reparte en tres pruebas, y no cuentan la misma historia. En Grok Build, DeepSWE v1.1 sube del 65% al 73% y lidera el gráfico publicado, justo por delante de GPT-5.6 Sol y de Muse Spark 1.3, en 72%. SWE-Atlas-QnA sube del 58% al 63%. Terminal-Bench 4.0 sube del 18% al 33%.
Ese último número es el que merece atención. 33% es una mejora grande sobre Grok 4.6 y queda lejos de Fable 5.1 (58%), GPT-6 Astra (56%) y Opus 5 (55%) en el mismo gráfico. Un agente de código que sobre todo implementa sobre un repositorio puede usar Grok 4.7. Un agente de código que vive en la terminal, lee la salida de los comandos y tiene que cerrar la sesión solo todavía tiene una herramienta mejor en lo alto de ese gráfico.
Fuente: Artificial Analysis — Intelligence Index y Coding Agent Index
Fuente: Artificial Analysis — DeepSWE, Terminal-Bench y SWE-Atlas-QnA en Grok Build
Estas notas usan Grok Build. El Intelligence Index de abajo usa un harness compartido para todos los modelos. Una ganancia en uno no se transfiere al otro.
Aspectos destacados del Intelligence Index
➤ La nota de portada es la menos interesante
Grok 4.7 (xhigh) marca 46. Grok 4.6 (xhigh) marca 44. En el mismo gráfico, GPT-5.6 Sol (max) queda en 47, Muse Spark 1.3 (max) en 48, y Fable 5.1 y GPT-6 Astra en 53. La página del modelo lo coloca 16º de 202 modelos de su clase, bien por encima de una mediana de 24, y lejos de los modelos que un equipo llamaría de frontera.
Dos puntos son una actualización, no una migración. Si lo único que necesitabas era "un modelo general más inteligente", quédate donde estás. El caso de Grok 4.7 está en los cortes debajo de ese promedio.
➤ El trabajo de conocimiento es donde "cerca de la frontera" es de verdad cierto
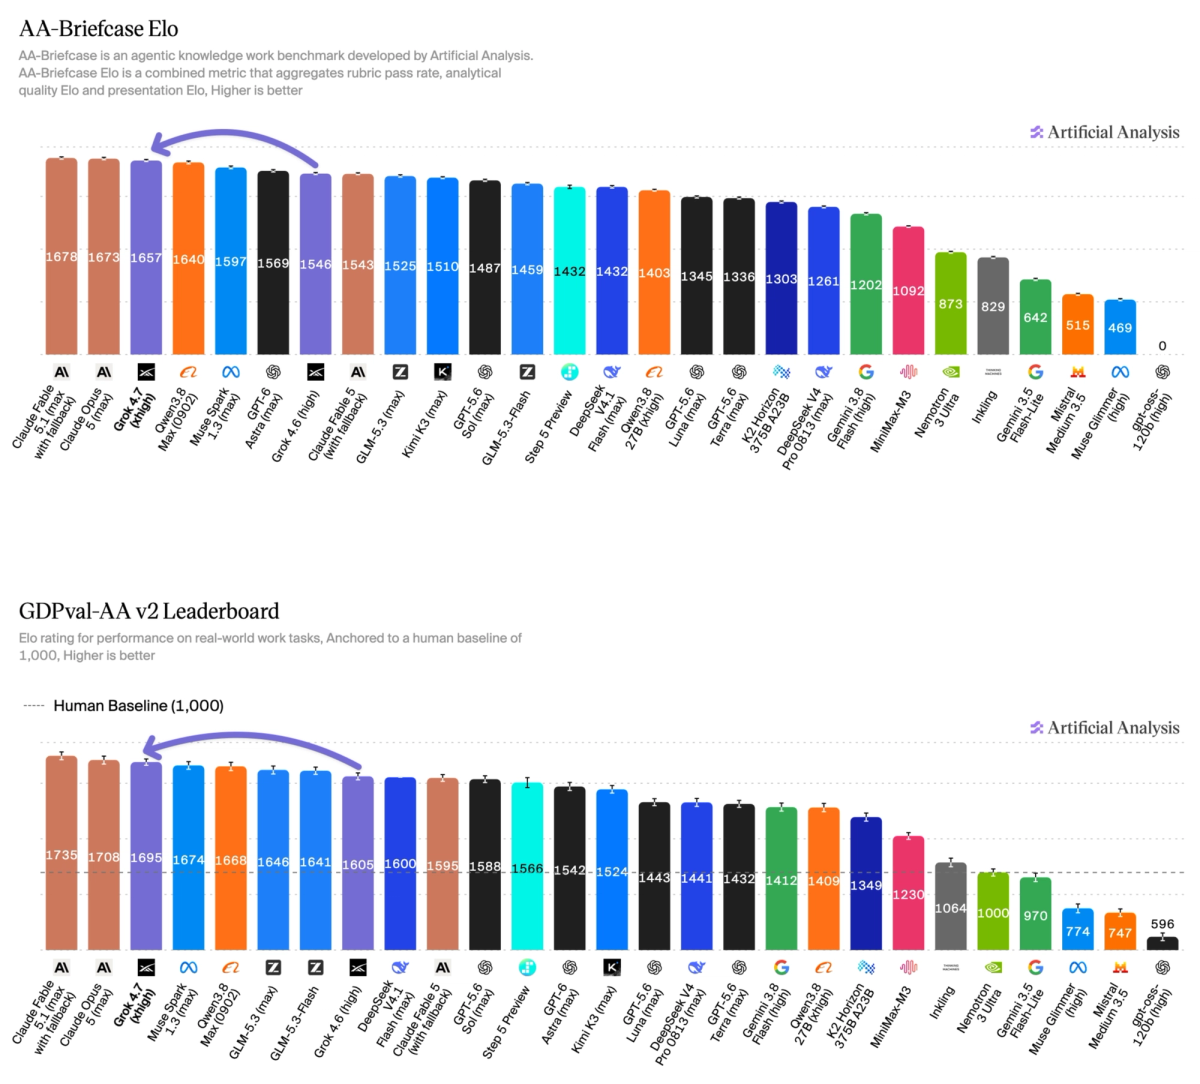
En AA-Briefcase, trabajo profesional largo con tareas encadenadas y un conjunto grande de archivos, Grok 4.7 marca 1.657 Elo. Son 111 por encima de Grok 4.6 (high), en 1.546, justo detrás de Fable 5.1 (1.678) y de Opus 5 (1.673), y por delante de GPT-6 Astra (1.569). En GDPval-AA, documentos, hojas de cálculo y diapositivas sacados de ocupaciones reales, marca 1.695, 90 por encima de 1.605. Fable sigue liderando, en 1.735.
La división de calidad importa más que el Elo. La calidad analítica salta de 1.690 a 1.994. La calidad de presentación baja de 1.519 a 1.499. El modelo mejoró en el razonamiento y no mejoró en el artefacto. Úsalo para poner a prueba un análisis, reconciliar un briefing largo o redactar la sustancia de un memorando. Pon una pasada de revisión, u otro modelo, en cualquier cosa que un cliente vaya a juzgar por cómo se ve.
➤ Pagas en tokens, no en una espera mucho mayor
Unos 81.000 tokens de salida por tarea se dividen en unos 22.000 tokens de respuesta y 59.000 tokens de razonamiento. La mayor parte del gasto nuevo es el modelo pensando, no el modelo hablando. Artificial Analysis lo sitúa en un 125% más de salida que Grok 4.6 (high), en 36.000, y un 196% más que Astra, en 27.000.
La sorpresa es el reloj. El tiempo de decodificación queda en unos 7,1 minutos por tarea de inteligencia, junto a 6,6 minutos tanto para Astra (max) como para Grok 4.6 (high). Esa cifra excluye el tiempo hasta el primer token. En esta prueba, el triple de tokens no significa el triple de espera, porque el caudal de la respuesta en prompts largos queda en unos 188 tokens por segundo.
El uso interactivo es otra prueba. La página del modelo mide 38,8 tokens de salida por segundo y coloca a Grok 4.7 en el puesto 154 de 202 en velocidad, con 0,85 segundos hasta el primer token. Un agente que se va y vuelve con un análisis no va a sentir los 38,8. Una persona mirando la burbuja del chat sí.
➤ La factualidad mejoró un poco
En AA-Omniscience, la tasa de alucinación baja del 34% de Grok 4.6 (high) al 29%. La exactitud se queda estable, 47% frente a 48%. El índice pasa de 30 a 32. Es un modelo más limpio, no un modelo cuidadoso. No es el tipo de caída que, sola, justifica cambiar un flujo sensible a los hechos. La revisión sigue en el circuito.
➤ El resto del índice empata
En el harness compartido, frente a Grok 4.6 (high), Terminal-Bench 4.0 sube 4,5 puntos y GDP.pdf sube 3,0. AA-LCR baja 3,7 y AutomationBench-AA baja 1,1. Pon ese Terminal-Bench al lado del salto del 18% al 33% dentro de Grok Build. El mismo nombre, otra prueba, otra historia. Citar cualquiera de los números solo va a desviar un plan de despliegue.
Fuente: Artificial Analysis — AA-Briefcase y GDPval-AA v2
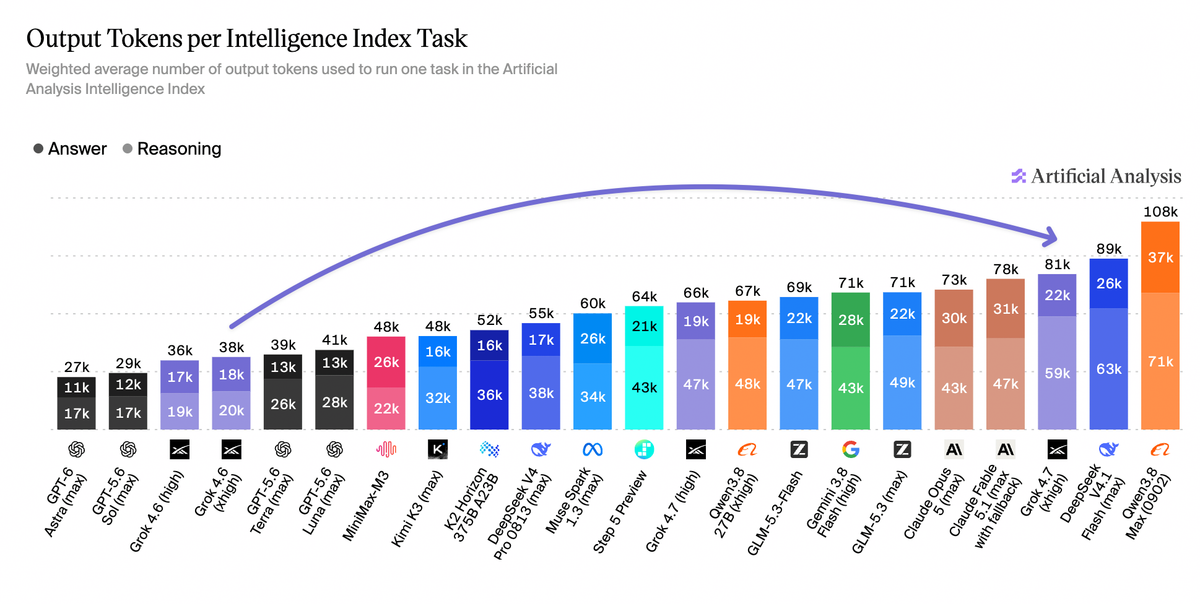
Fuente: Artificial Analysis — tokens de salida por tarea del Intelligence Index
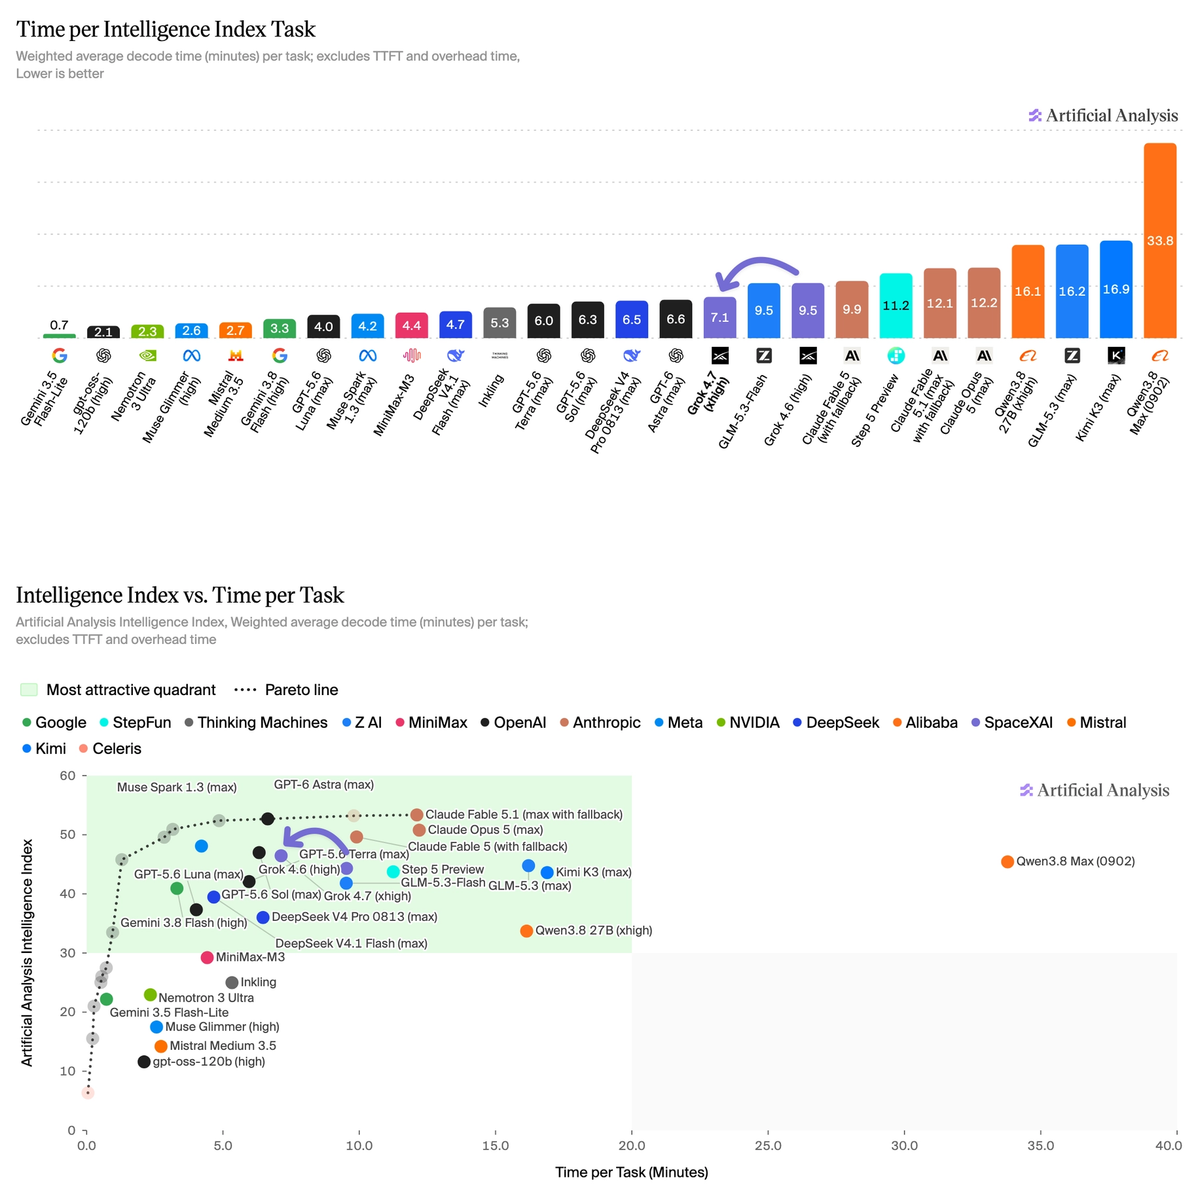
Fuente: Artificial Analysis — tiempo por tarea del Intelligence Index
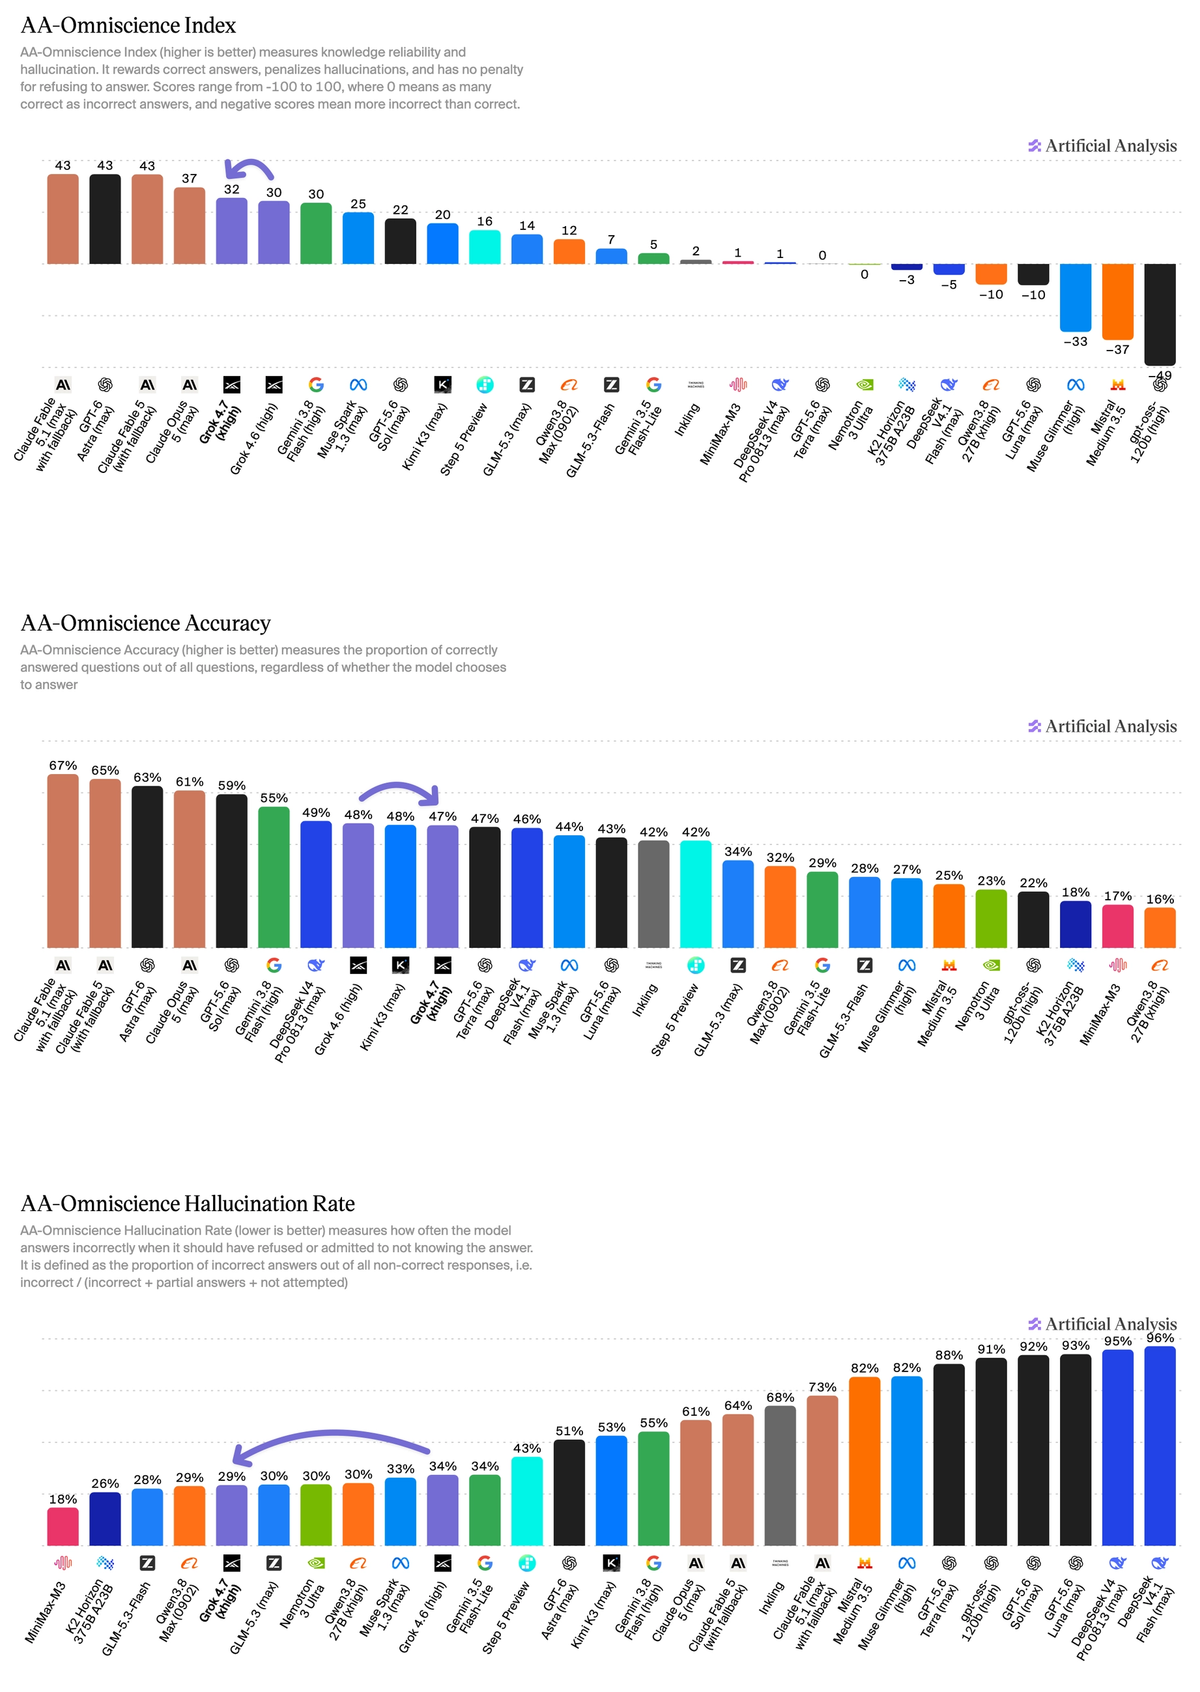
Fuente: Artificial Analysis — AA-Omniscience
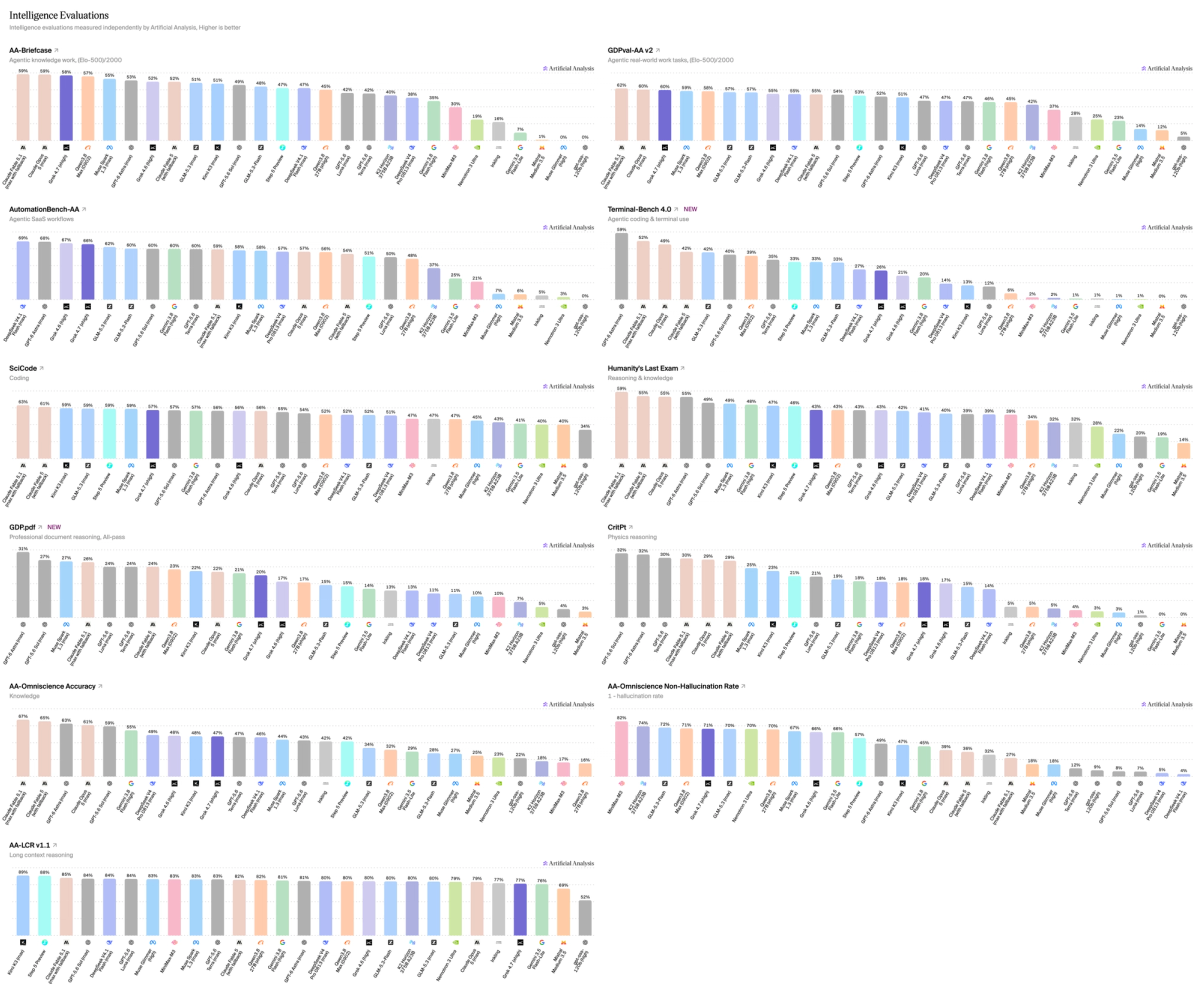
Fuente: Artificial Analysis — desglose de las evaluaciones del Intelligence Index
Lo que reporta xAI, y cómo pesarlo
El post de lanzamiento de xAI es el argumento de la empresa: trabajo más largo, más autoverificación, el mismo precio y la misma velocidad que Grok 4.6. La tabla de abajo compara Grok 4.7 (xHigh) con Grok 4.6 (High), GPT-5.6 Sol (Max) y Fable 5.1 (Max). Trátala como una hipótesis para probar, no como un segundo Intelligence Index.
La fila que conversa con la historia independiente de código es CursorBench. xAI pone a Grok 4.7 (xHigh) en 46,3% y unos US$ 6,01 por tarea, frente a 41,7% y US$ 8,23 de Sol (Max), y 51,8% y US$ 17,28 de Fable (Max). Un esfuerzo más bajo es un control de verdad, no una nota al pie: High queda en 43,9% a US$ 4,69, Medium en 41,6% a US$ 3,49, Low en 33,1% a US$ 1,58. Si el agente no necesita el ajuste de arriba, la factura baja más rápido que la nota.
Las filas que piden cuidado son las de especialista. EEBench, en 64%, lidera los cuatro modelos que xAI eligió mostrar, y el benchmark jurídico de Harvey, en 19,6%, es varias veces Sol (2,5%) y Fable (6,7%). Son motivos para correr un piloto de dominio sobre tus propios casos. No son una certificación. 19,6% sigue siendo una tasa absoluta de aprobación baja. HealthBench Professional, en 56,7%, va en el sentido contrario y queda detrás de Sol y de Fable. Un modelo con un pico jurídico y una nota clínica más débil es candidato a especialista, no una mejora general.
Una trampa de nombre queda abierta. Terminal-Bench 4.0 es 38,0% en la tabla de xAI, 33% en la corrida de Artificial Analysis en Grok Build, y solo 4,5 puntos por encima de Grok 4.6 en el harness compartido. Quien compara "Terminal-Bench" entre estas páginas sin el harness en la frase está comparando exámenes distintos.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Entrada / salida, US$ por millón de tokens | US$ 2 / US$ 6 | US$ 2 / US$ 6 | US$ 4 / US$ 20 | US$ 10 / US$ 50 |
| CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0%* | 65,2% | 72,7% | 70,0% |
| EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
| AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | 37,3% | 57,9% |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
* xAI marca el resultado de DeepSWE de Grok 4.7 como esfuerzo high.
La ventana de contexto es de 500.000 tokens, con entrada de texto e imagen y salida de texto. xAI también dice que el modelo lidera sus propias pruebas de seguridad, incluido un 62,4% en el benchmark de bioseguridad de LatchBio y un 3,3% de paso de prompts de riesgo en HackerBench v0.3. Son mediciones de xAI sobre pruebas de xAI. Para un uso sensible, son un punto de partida para la revisión, junto con tu propia política de acceso.
En la práctica
- Para agentes de código pesados en repositorio: pilotea Grok 4.7 en xhigh. El Coding Agent Index y DeepSWE son donde el precio parece racional. Mantén un modelo de frontera en las sesiones largas de terminal.
- Para análisis, briefings largos y trabajo de conocimiento en varios pasos: este es el caso independiente más fuerte. La calidad analítica entró en la franja de frontera. No publiques las diapositivas ni el entregable formateado sin una pasada de revisión.
- Para un cambio general desde Astra, Fable o Sol: el Intelligence Index no lo sostiene. Dos puntos, con un conteo de tokens mucho mayor, es un cambio lateral.
- Para el presupuesto: espera cerca del doble del gasto de salida de Grok 4.6 en las tareas difíciles, y aun así una factura de salida menor que la de Astra en el mismo índice. Baja el esfuerzo a high o medium cuando la tarea lo permita. La curva de CursorBench muestra la nota bajando más despacio que el costo.
- Para un chat que tiene que sentirse instantáneo: los 38,8 tokens por segundo de la página del modelo son el reloj que importa. Usa la variante rápida solo si esa latencia vale el doble del precio.
- Para hechos, trabajo jurídico o clínico: las alucinaciones bajaron, no se desplomaron. Harvey y EEBench valen una evaluación privada sobre tus propios archivos. No son motivo para saltarse la revisión.
La comparación que lo decide es un corte de tu propio trabajo: un repositorio, un briefing largo, una presentación, ejecutados en Grok 4.7 y en el modelo que usas hoy. Tess está hecha para esa prueba. Varios modelos, un workspace, la misma tarea.
Gráficos y metodología originales: Artificial Analysis — “Benchmarking Grok 4.7”, publicado el 21 de septiembre de 2026. Perfil de operación: Artificial Analysis — Grok 4.7 (xhigh). Notas reportadas por la empresa: xAI — “Introducing Grok 4.7”. Los costos de salida en este artículo usan esos conteos y esos precios de token publicados, y cubren solo los tokens de salida.