GPT-6 Sol y Luna: la mitad de la factura, un entregable más fino
GPT-6 Sol y GPT-6 Luna, lanzados el 22 de septiembre de 2026, no son una nueva cima del Intelligence Index. Quedan en el mismo barrio que GPT-5.6, por cerca de la mitad del precio de la API. Esa es la parte que vale el cambio. La parte que no vale es el entregable: en el trabajo de conocimiento, los dos modelos se quedaron más cortos y dejan fuera piezas que la rúbrica pedía.
Sol es el modelo de código y de agente. En la API de OpenAI el id es gpt-6-sol, a US$ 2 por millón de tokens de entrada y US$ 10 por millón de tokens de salida. Luna es el modelo de volumen, gpt-6-luna, a US$ 0,10 y US$ 0,50. La frase de OpenAI es que llevan las ganancias de Astra a algo que se puede ejecutar todo el día. La frase de Artificial Analysis es más afilada. El índice apenas se movió. La factura sí. Una clase de trabajo profesional empeoró.
Por qué esto importa
Un workspace que ya ejecuta Astra, Opus 5.5 y GPT-5.6 Sol no necesita dos nombres nuevos. Necesita saber qué tráfico cambia de modelo, y qué trabajo debe quedarse donde el entregable ya era bueno.
Sol está hecho para código complejo y flujos agénticos. Su ventana de contexto es de 1.050.000 tokens, la salida máxima es de 128.000, y el corte de conocimiento es el 20 de abril de 2026. El esfuerzo predeterminado es medium. Las notas de abajo son max. El papel publicado de Luna es trabajo enfocado y de alto volumen: un resumen, una extracción, una respuesta corta. Su corte de conocimiento es el 18 de mayo de 2026.
Los dos están en la API hoy. ChatGPT Work y Codex los reciben para Plus, Pro, Business, Enterprise y Edu. Free y Go pueden probar Luna en la app de escritorio. La app y el sitio de ChatGPT se liberan a lo largo del día.
La factura
La tabla es la mitad de la de GPT-5.6, que OpenAI describe como un 50% por debajo del precio promocional de esa generación. La lectura de caché sigue en el 10% de la entrada. La escritura de caché sigue en 1,25 veces la entrada.
| Por 1 millón de tokens | GPT-6 Sol | GPT-5.6 Sol | GPT-6 Luna | GPT-5.6 Luna |
|---|---|---|---|---|
| Entrada | US$ 2 | US$ 4 | US$ 0,10 | US$ 0,20 |
| Salida | US$ 10 | US$ 20 | US$ 0,50 | US$ 1,20 |
| Lectura de caché | US$ 0,20 | US$ 0,40 | US$ 0,01 | US$ 0,02 |
| Escritura de caché | US$ 2,50 | US$ 5 | US$ 0,125 | US$ 0,25 |
La factura de la tarea baja más o menos en la misma proporción, y no porque los modelos se hayan vuelto más concisos. En el Intelligence Index, Sol en max usa 31.000 tokens de salida por tarea, frente a 29.000 de GPT-5.6 Sol en max. Luna usa 51.000, frente a 41.000. Un poco más de tokens, mucho menos dinero. Artificial Analysis pone la corrida del índice en US$ 1,06 por tarea para Sol en max, frente a US$ 1,99, cerca de la mitad. Luna en max queda en US$ 0,07 frente a US$ 0,18, cerca de un 60% menos.
Esos US$ 1,06 son la tarea del índice de inteligencia. No son la tarea del agente de código, que Sol en max ejecuta a US$ 2,99, también cerca de la mitad de GPT-5.6 Sol en max. Mantén las dos facturas separadas.
Dos interruptores devuelven el descuento. El modo rápido es 2 veces la tarifa. Y cualquier pedido cuya entrada pase de 272.000 tokens se reprecio en el prompt entero: entrada y caché a 2 veces, salida a 1,5 veces. Un contexto largo de agente no es el precio de la tabla. Batch y Flex salen a la mitad de standard, encima de la nueva lista.
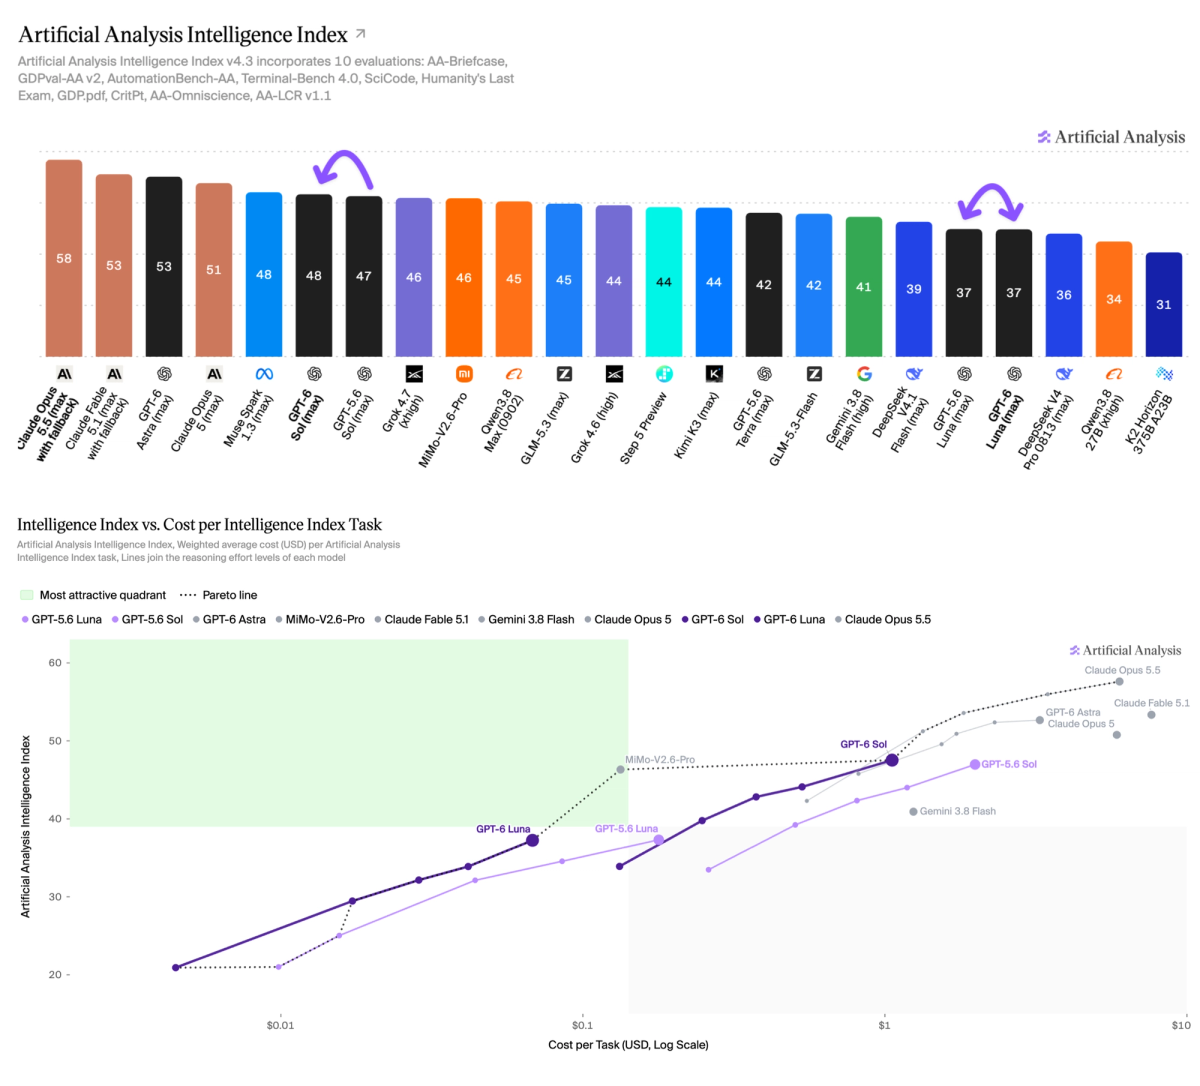
Fuente: Artificial Analysis. Sol en max marca 48, un punto por encima de GPT-5.6 Sol en max. Luna en max se queda en 37. Lo que se movió fue la curva de costo.
Al nivel del índice, detrás de los modelos que ya conoces
En el Intelligence Index de Artificial Analysis, Sol en max marca 48. GPT-5.6 Sol en max marca 47. Luna en max marca 37, lo mismo que GPT-5.6 Luna en max. "Al nivel" es la palabra justa. Un paso de un punto no es un nuevo nivel.
El mismo gráfico todavía tiene a Claude Opus 5.5 en 58, y a GPT-6 Astra y Claude Fable 5.1 en 53. Sol no les quitó el trabajo. Se quedó con el tramo de la frontera de costo en el que un equipo ya pagaba precio de Sol. La línea de esfuerzo de GPT-6 Sol queda a la izquierda de GPT-5.6 Sol. Luna hace lo mismo, por debajo. OpenAI ocupó esa frontera bajando el precio, no superando a Astra.
El código se movió un poco. La factura se movió mucho.
En el harness Codex de OpenAI, el Coding Agent Index pone a Sol en max en 57, 2 por encima de GPT-5.6 Sol en max, en 55. Luna en max marca 41, 2 por debajo de 43. La ganancia de Sol es Terminal-Bench 4.0 en 43% frente a 37%, y SWE-Atlas-QnA en 58% frente a 54%. La caída de Luna es SWE-Atlas-QnA en 44% frente a 49%, y DeepSWE v1.1 en 64% frente a 66%.
A US$ 2,99 por tarea de código, Sol en max cuesta cerca de la mitad que su predecesor y queda en la frontera de costo de código. Fable 5.1 y Astra, en sus propios harnesses, siguen en 62. Opus 5 está en 60. Grok 4.7 en Grok Build está en 56, un punto por debajo de Sol, en un harness distinto y en una factura distinta. No leas 57 como un adelantamiento de esos modelos.
Hay un segundo número de Terminal-Bench, y no es este. Dentro del Intelligence Index, el Terminal-Bench 4.0 de Sol es 44% frente a 40%, y el de Luna es 13% frente a 12%. La cifra de 43% frente a 37% es el Coding Agent Index, en Codex. Etiquétalas, o se van a citar como una sola nota.
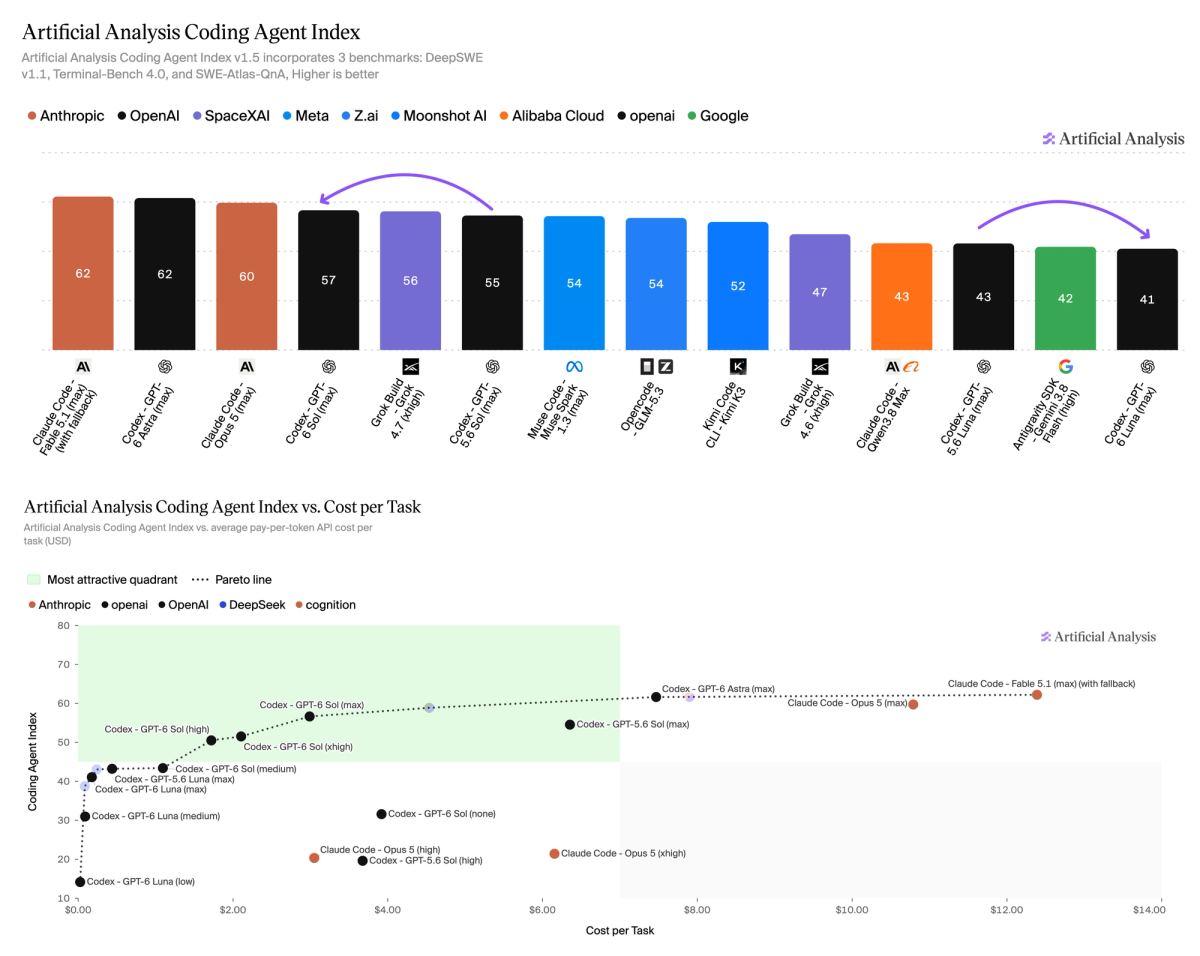
Fuente: Artificial Analysis. Harness Codex. Sol en max queda en 57 y en la frontera de costo. Luna en max queda en 41, dos puntos por debajo de GPT-5.6 Luna.
La caída de la alucinación es sobre todo un rechazo
Los dos modelos inventan menos en AA-Omniscience, en el esfuerzo máximo. La tasa de alucinación de Sol pasa del 92% al 60%. La de Luna pasa del 93% al 77%. El índice, que premia una respuesta correcta y castiga una incorrecta, mueve a Sol de 22 a 27 y a Luna de −10 a 1.
Lee el mecanismo antes de tratar eso como un modelo más inteligente. Sol intenta el 83% de las preguntas, frente al 99% de GPT-5.6 Sol en max. Las respuestas incorrectas bajan cerca de un cuarto. La exactitud también baja, del 59% al 54%. La exactitud de Luna se queda casi plana, 44% frente a 43%, mientras responde menos preguntas. Sol se volvió más seguro al rechazar. No acertó con más frecuencia.
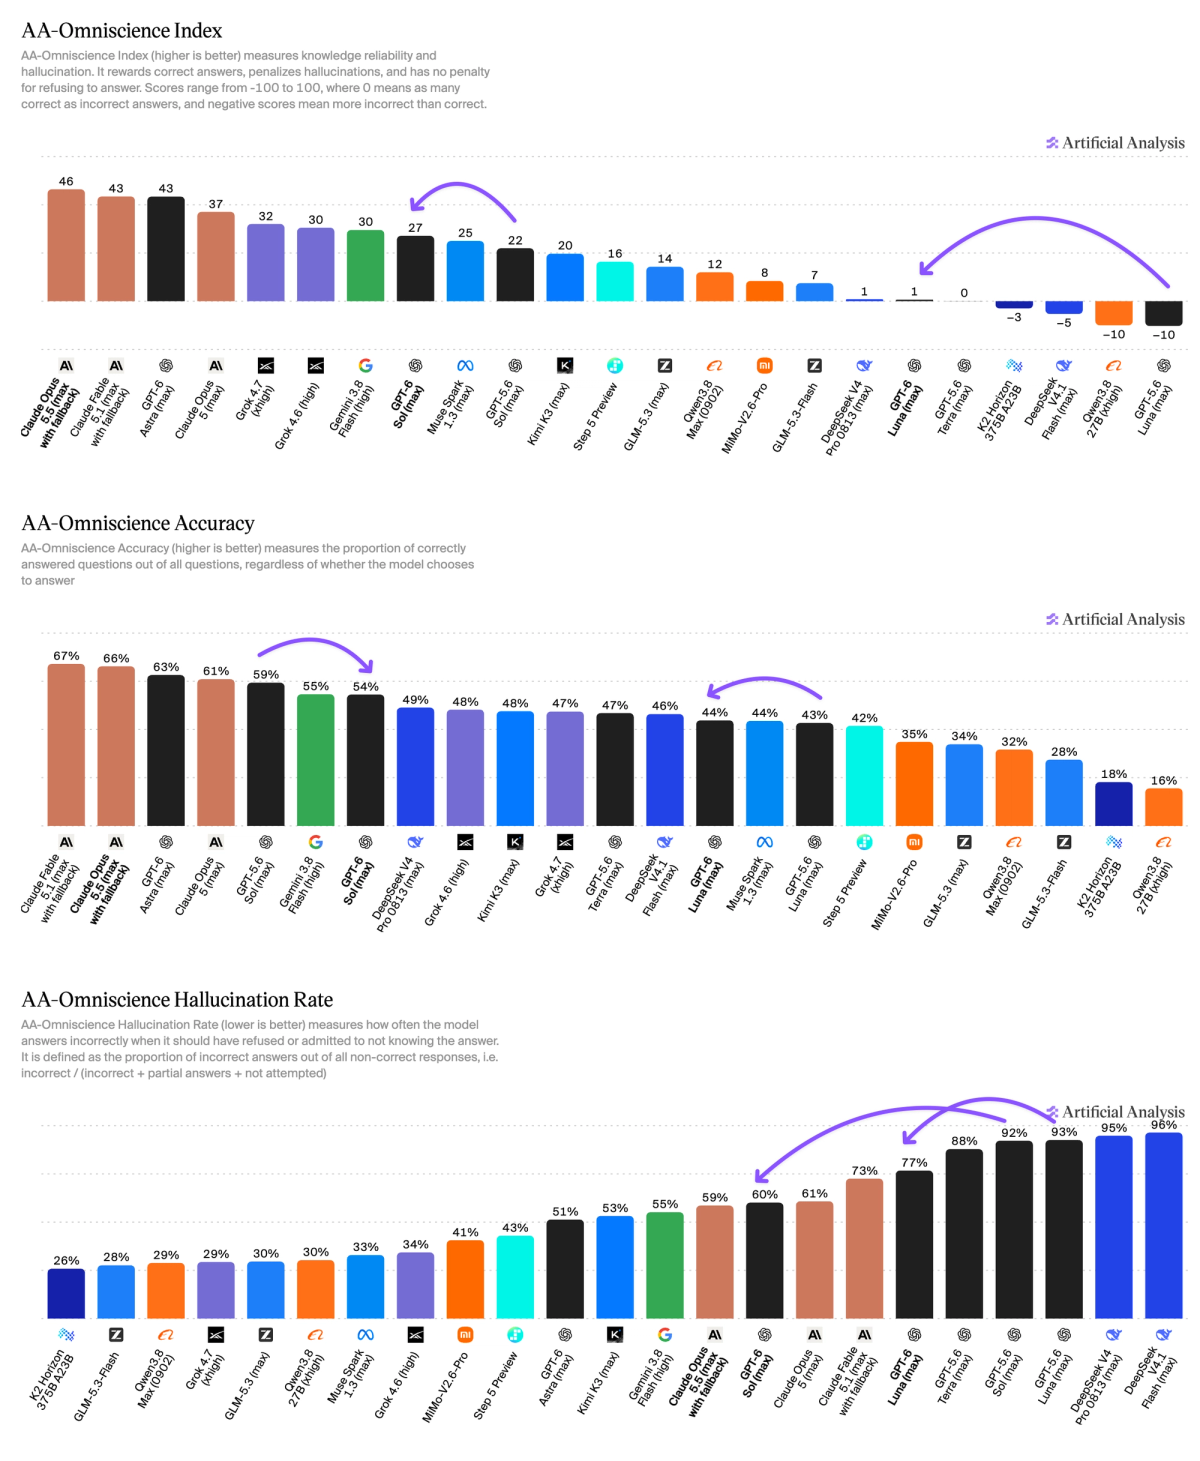
Fuente: Artificial Analysis. La tasa de alucinación de Sol baja del 92% al 60%. La exactitud baja con ella, del 59% al 54%.
El entregable se quedó más fino
La regresión está en el trabajo de conocimiento, y Artificial Analysis lo revisó a mano. En GDPval-AA v2.1, tareas reales en 44 ocupaciones, Sol en max baja cerca de 100 Elo. El gráfico pone a GPT-5.6 Sol en max en 1588 y a GPT-6 Sol en max en 1487. Luna en max baja cerca de 75 Elo, a 1367. Astra queda en 1542 en el mismo tablero. Opus 5.5 queda en 1846. Un recorte de precio no cierra esa distancia.
En AA-Briefcase, Sol se queda al mismo nivel y Luna baja cerca de 45 Elo. Los fallos son de presentación y de ítems de rúbrica que faltan, no un hecho incorrecto al azar. Salida más corta, piezas obligatorias fuera. Para una presentación, un briefing o un conjunto de archivos de varias semanas, ese es el modo de fallo. El modelo termina. El entregable queda más fino que el que te entregaba GPT-5.6.
AutomationBench-AA sí subió: Sol 62% frente a 60%, Luna 53% frente a 50%. Eso es una tasa de aprobación de flujo, no un documento. No cancela la caída de GDPval.
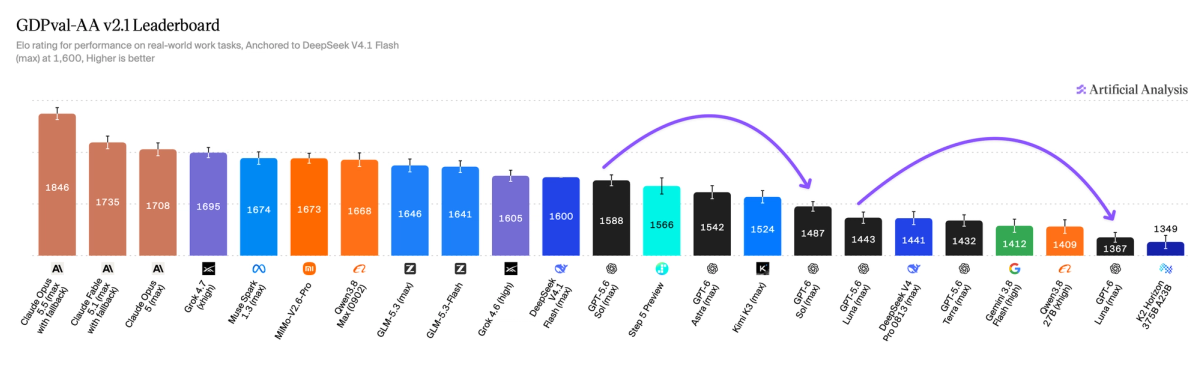
Fuente: Artificial Analysis. Sol baja cerca de 100 Elo respecto de GPT-5.6 Sol. Luna baja cerca de 75. Opus 5.5 sigue en 1846.
En la práctica
- Pasa el tráfico de GPT-5.6 Sol y Luna a gpt-6-sol y gpt-6-luna cuando el trabajo tenga la misma forma. El Intelligence Index se queda plano. La tabla queda en cerca de la mitad, y los modelos gastan un poco más de tokens, no menos.
- No retires Astra ni Opus 5.5 porque Sol en max marca 48. En este índice Astra está en 53 y Opus 5.5 en 58. Sol ganó la frontera de costo por debajo de ellos.
- Mantén briefings, presentaciones y archivos largos de trabajo de conocimiento en el modelo que ya ganaba GDPval. Sol bajó cerca de 100 Elo y Luna cerca de 75, en entregables más cortos que se saltan ítems de la rúbrica.
- Trata la caída de alucinación de Sol como una política de rechazo. La tasa pasó del 92% al 60% porque intenta el 83% de las preguntas en lugar del 99%. La exactitud bajó del 59% al 54%. Úsalo cuando el silencio sea más barato que una respuesta incorrecta.
- Mantén separadas las dos cifras de Terminal-Bench. 43% frente a 37% es Sol en el Coding Agent Index, en Codex. 44% frente a 40% es Sol en la evaluación del Intelligence Index. La nota de código de Luna bajó, 41 frente a 43.
- Asume que la tabla de la mitad del precio se detiene en 272.000 tokens de entrada. Pasado eso, el pedido entero queda a 2 veces en entrada y caché y a 1,5 veces en salida. El modo rápido es 2 veces y se gasta el descuento.
- Los gráficos de Sol son esfuerzo max. El predeterminado de la API es medium. En Sol, Chat Completions solo hace function-call con el esfuerzo de razonamiento en none. Las herramientas van en la Responses API.
Fuentes: Introducing GPT-6 Sol and Luna, GPT-6 Sol y GPT-6 Luna en la API de OpenAI, y Artificial Analysis. Los gráficos y las caídas de Elo son de Artificial Analysis. La tabla de precios es de OpenAI.