GPT-6 Sol e Luna: metade da conta, um entregável mais fino
O GPT-6 Sol e o GPT-6 Luna, lançados em 22 de setembro de 2026, não são um novo topo do Intelligence Index. Ficam na mesma vizinhança do GPT-5.6, por cerca de metade do preço da API. Essa é a parte que vale a troca. A parte que não vale é o entregável: no trabalho de conhecimento, os dois modelos ficaram mais curtos e deixam de fora peças que a rubrica pedia.
O Sol é o modelo de código e de agente. Na API da OpenAI o id é gpt-6-sol, a US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. A Luna é o modelo de volume, gpt-6-luna, a US$ 0,10 e US$ 0,50. A frase da OpenAI é que eles levam os ganhos do Astra para algo que dá para rodar o dia inteiro. A frase da Artificial Analysis é mais afiada. O índice mal se moveu. A conta se moveu. Uma classe de trabalho profissional piorou.
Por que isso importa
Um workspace que já roda Astra, Opus 5.5 e GPT-5.6 Sol não precisa de dois nomes novos. Precisa saber qual tráfego muda de modelo, e qual trabalho deve ficar onde o entregável já era bom.
O Sol foi feito para código complexo e fluxos agênticos. A janela de contexto é de 1.050.000 tokens, a saída máxima é de 128.000, e o corte de conhecimento é 20 de abril de 2026. O esforço padrão é medium. As notas abaixo são max. O papel publicado da Luna é trabalho focado e de alto volume: um resumo, uma extração, uma resposta curta. O corte de conhecimento dela é 18 de maio de 2026.
Os dois estão na API hoje. O ChatGPT Work e o Codex os recebem para Plus, Pro, Business, Enterprise e Edu. Free e Go podem experimentar a Luna no app de desktop. O app e o site do ChatGPT liberam ao longo do dia.
A conta
A tabela é metade da do GPT-5.6, que a OpenAI descreve como 50% abaixo do preço promocional daquela geração. A leitura de cache continua em 10% da entrada. A gravação de cache continua em 1,25 vez a entrada.
| Por 1 milhão de tokens | GPT-6 Sol | GPT-5.6 Sol | GPT-6 Luna | GPT-5.6 Luna |
|---|---|---|---|---|
| Entrada | US$ 2 | US$ 4 | US$ 0,10 | US$ 0,20 |
| Saída | US$ 10 | US$ 20 | US$ 0,50 | US$ 1,20 |
| Leitura de cache | US$ 0,20 | US$ 0,40 | US$ 0,01 | US$ 0,02 |
| Gravação de cache | US$ 2,50 | US$ 5 | US$ 0,125 | US$ 0,25 |
A conta da tarefa cai mais ou menos na mesma proporção, e não porque os modelos ficaram mais concisos. No Intelligence Index, o Sol no max usa 31.000 tokens de saída por tarefa, contra 29.000 do GPT-5.6 Sol no max. A Luna usa 51.000, contra 41.000. Um pouco mais de tokens, bem menos dinheiro. A Artificial Analysis coloca a rodada do índice em US$ 1,06 por tarefa para o Sol no max, contra US$ 1,99, cerca da metade. A Luna no max fica em US$ 0,07 contra US$ 0,18, cerca de 60% a menos.
Esses US$ 1,06 são a tarefa do índice de inteligência. Não são a tarefa do agente de código, que o Sol no max roda a US$ 2,99, também cerca da metade do GPT-5.6 Sol no max. Mantenha as duas faturas separadas.
Dois interruptores devolvem o desconto. O modo rápido é 2 vezes a tarifa. E qualquer pedido cuja entrada passe de 272.000 tokens é reprecificado no prompt inteiro: entrada e cache a 2 vezes, saída a 1,5 vez. Um contexto longo de agente não é o preço da tabela. Batch e Flex saem pela metade do standard, por cima da nova tabela.
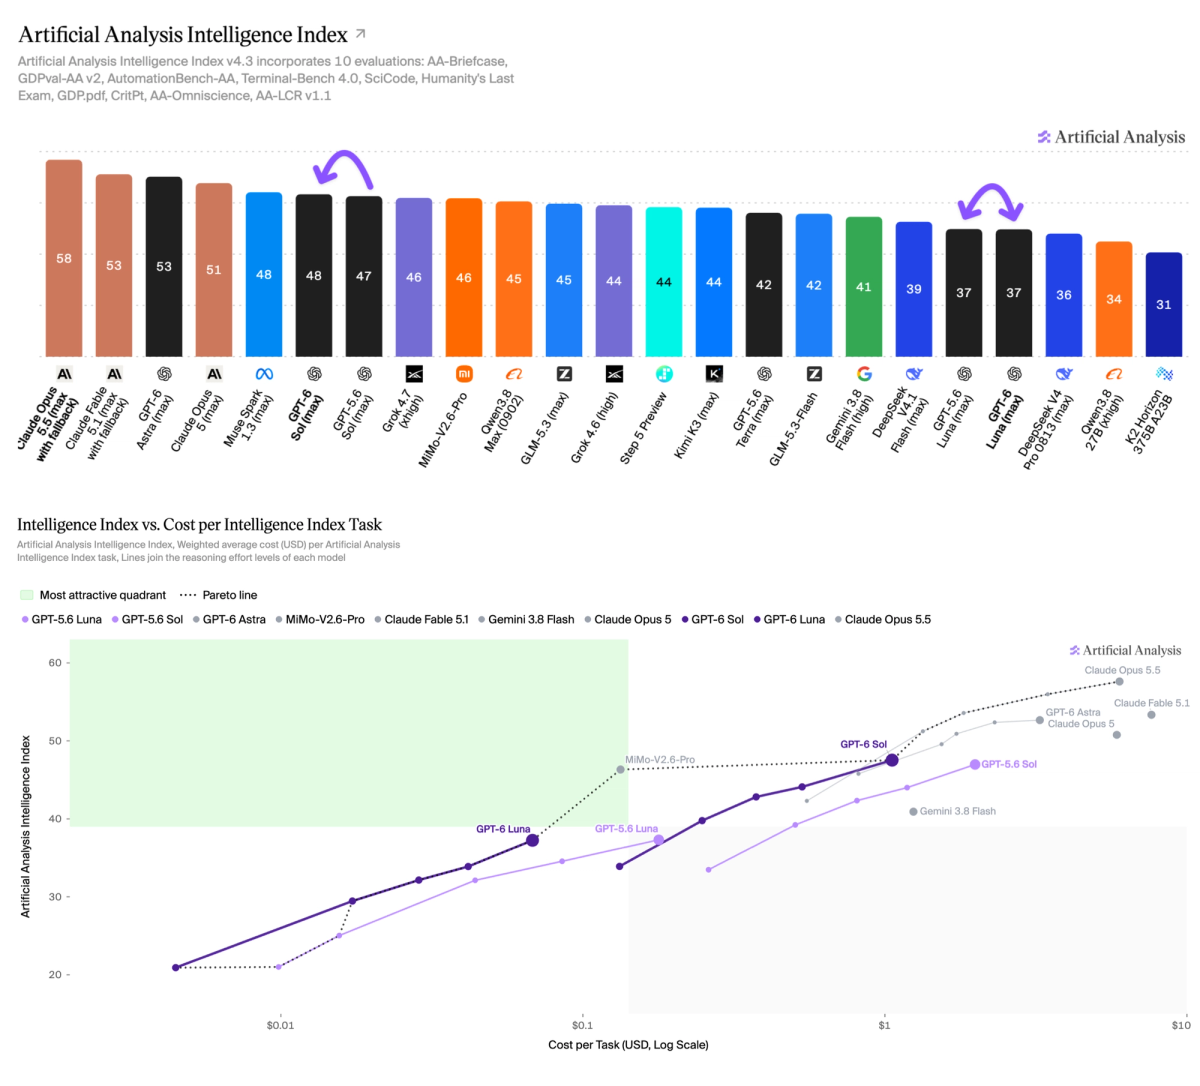
Fonte: Artificial Analysis. O Sol no max marca 48, um ponto acima do GPT-5.6 Sol no max. A Luna no max fica em 37. O que se moveu foi a curva de custo.
No nível do índice, atrás dos modelos que você já conhece
No Intelligence Index da Artificial Analysis, o Sol no max marca 48. O GPT-5.6 Sol no max marca 47. A Luna no max marca 37, o mesmo que o GPT-5.6 Luna no max. "No nível" é a palavra certa. Um passo de um ponto não é um novo patamar.
O mesmo gráfico ainda tem o Claude Opus 5.5 em 58, e o GPT-6 Astra e o Claude Fable 5.1 em 53. O Sol não tomou o trabalho deles. Tomou o trecho da fronteira de custo em que um time já pagava preço de Sol. A linha de esforço do GPT-6 Sol fica à esquerda do GPT-5.6 Sol. A Luna faz o mesmo, abaixo. A OpenAI ocupou essa fronteira cortando preço, não passando do Astra.
O código se moveu um pouco. A fatura se moveu muito.
No harness Codex da OpenAI, o Coding Agent Index coloca o Sol no max em 57, 2 acima do GPT-5.6 Sol no max, em 55. A Luna no max marca 41, 2 abaixo de 43. O ganho do Sol é o Terminal-Bench 4.0 em 43% contra 37%, e o SWE-Atlas-QnA em 58% contra 54%. A queda da Luna é o SWE-Atlas-QnA em 44% contra 49%, e o DeepSWE v1.1 em 64% contra 66%.
A US$ 2,99 por tarefa de código, o Sol no max custa cerca da metade do antecessor e fica na fronteira de custo de código. O Fable 5.1 e o Astra, nos harnesses deles, ainda estão em 62. O Opus 5 está em 60. O Grok 4.7 no Grok Build está em 56, um ponto abaixo do Sol, num harness diferente e numa conta diferente. Não leia 57 como uma ultrapassagem desses modelos.
Há um segundo número de Terminal-Bench, e não é este. Dentro do Intelligence Index, o Terminal-Bench 4.0 do Sol é 44% contra 40%, e o da Luna é 13% contra 12%. A cifra de 43% contra 37% é o Coding Agent Index, no Codex. Rotule as duas, ou vão ser citadas como uma nota só.
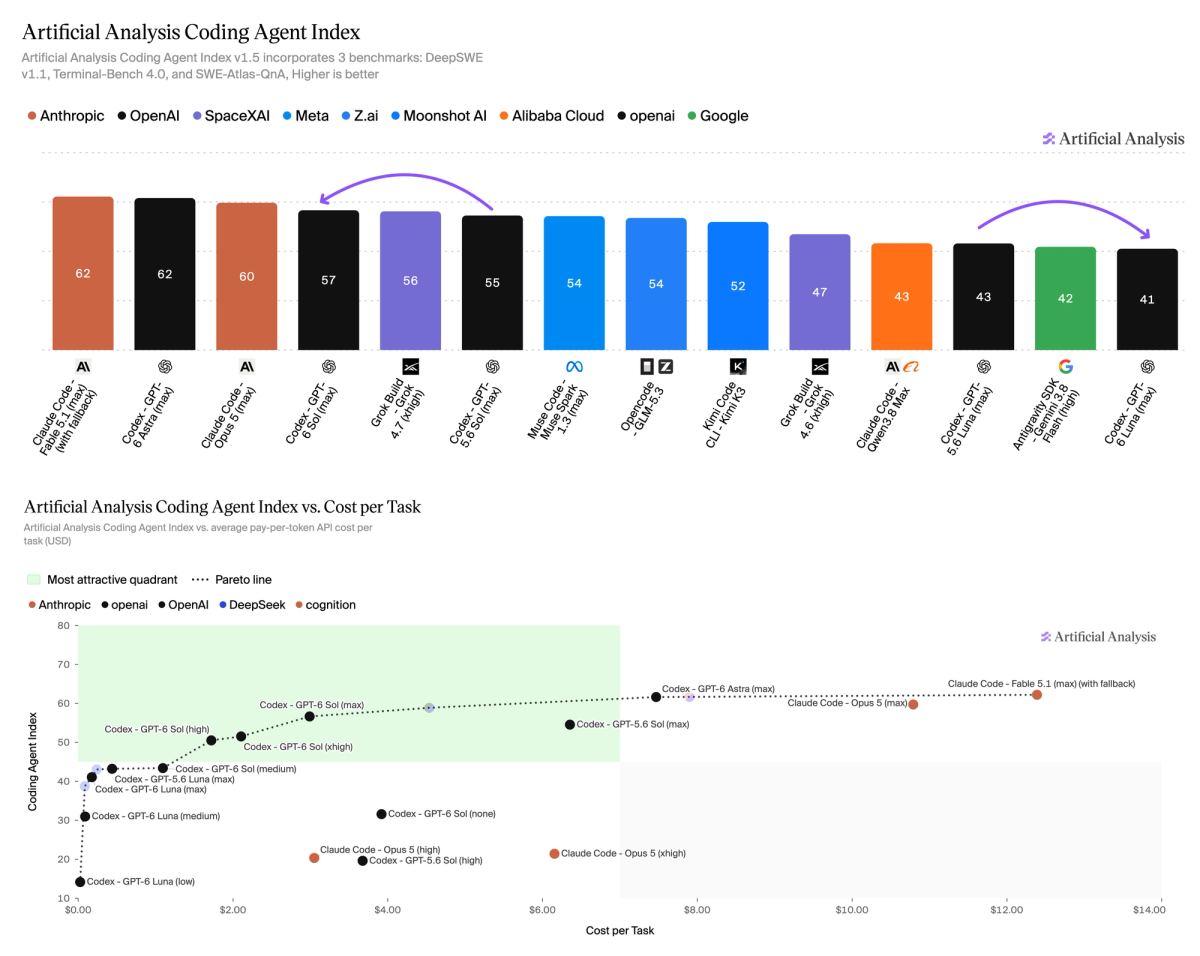
Fonte: Artificial Analysis. Harness Codex. O Sol no max fica em 57 e na fronteira de custo. A Luna no max fica em 41, dois pontos abaixo do GPT-5.6 Luna.
A queda da alucinação é sobretudo uma recusa
Os dois modelos inventam menos no AA-Omniscience, no esforço máximo. A taxa de alucinação do Sol vai de 92% para 60%. A da Luna vai de 93% para 77%. O índice, que premia uma resposta certa e pune uma errada, move o Sol de 22 para 27 e a Luna de −10 para 1.
Leia o mecanismo antes de tratar isso como um modelo mais inteligente. O Sol tenta 83% das perguntas, contra 99% do GPT-5.6 Sol no max. As respostas erradas caem cerca de um quarto. A acurácia também cai, de 59% para 54%. A acurácia da Luna fica quase estável, 44% contra 43%, enquanto ela responde menos perguntas. O Sol ficou mais seguro ao recusar. Não ficou certo com mais frequência.
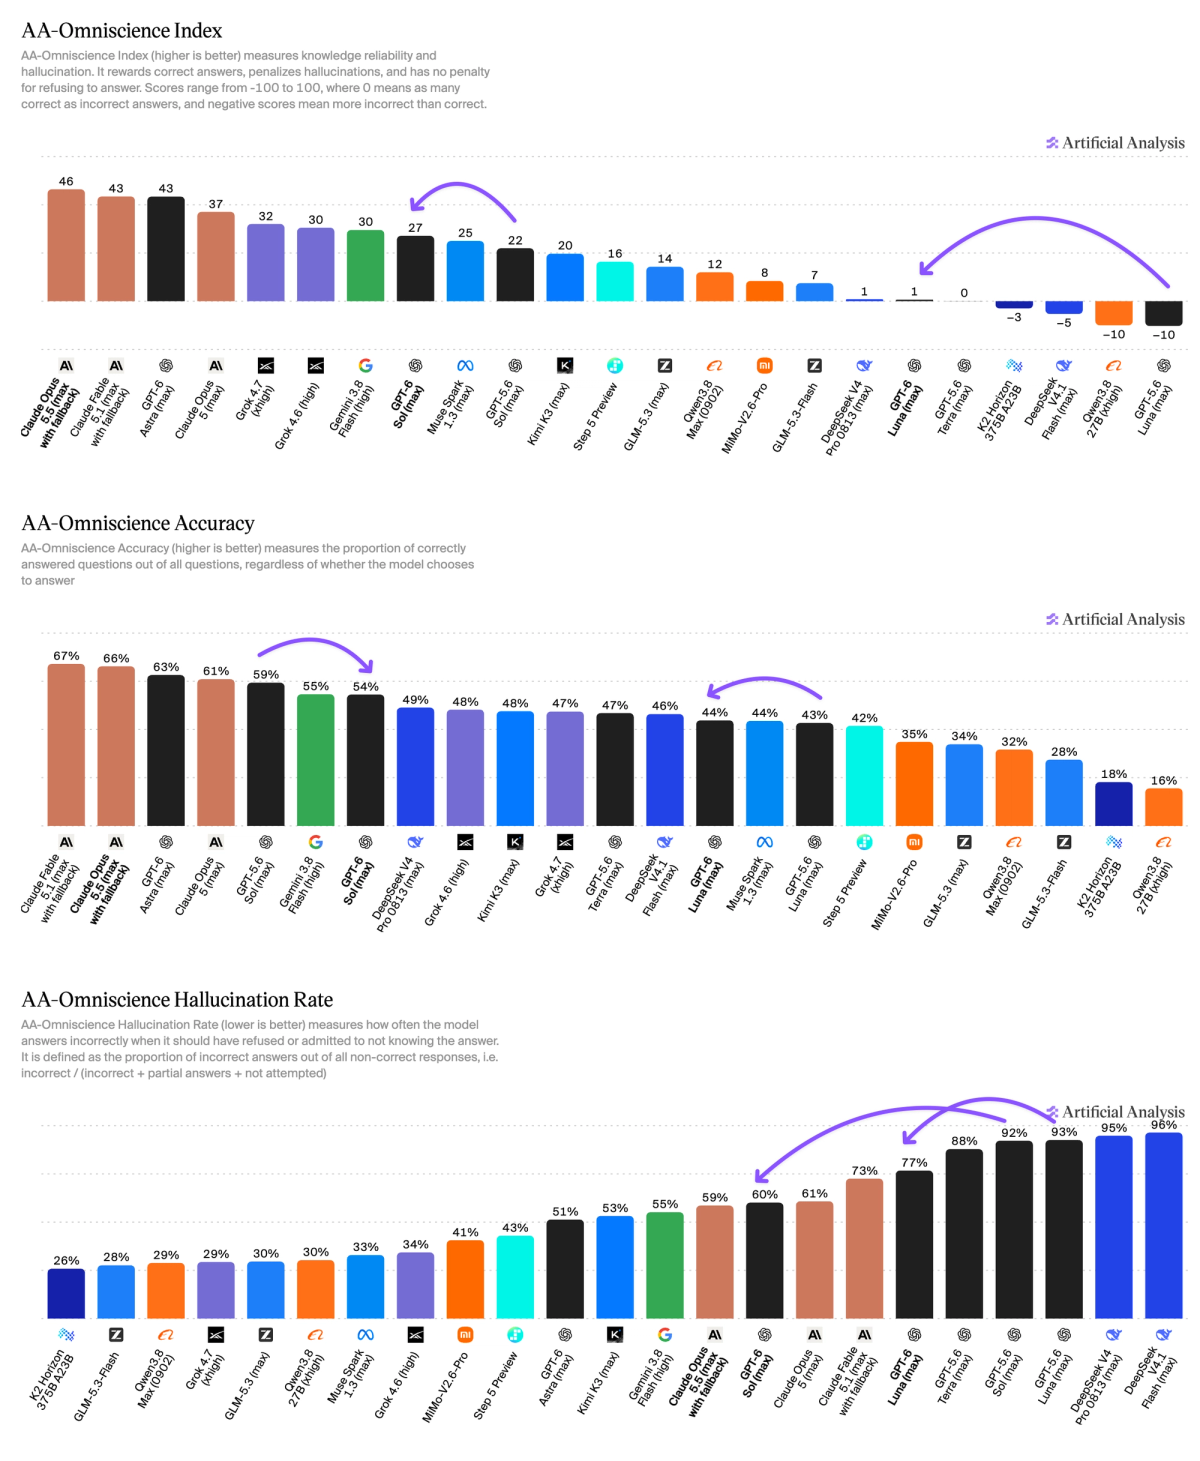
Fonte: Artificial Analysis. A taxa de alucinação do Sol cai de 92% para 60%. A acurácia cai junto, de 59% para 54%.
O entregável ficou mais fino
A regressão está no trabalho de conhecimento, e a Artificial Analysis conferiu à mão. No GDPval-AA v2.1, tarefas reais em 44 ocupações, o Sol no max cai cerca de 100 Elo. O gráfico coloca o GPT-5.6 Sol no max em 1588 e o GPT-6 Sol no max em 1487. A Luna no max cai cerca de 75 Elo, para 1367. O Astra fica em 1542 no mesmo painel. O Opus 5.5 fica em 1846. Um corte de preço não fecha essa distância.
No AA-Briefcase, o Sol fica no mesmo nível e a Luna cai cerca de 45 Elo. As falhas são de apresentação e de itens de rubrica que faltam, não um fato errado ao acaso. Saída mais curta, peças obrigatórias de fora. Para uma apresentação, um briefing ou um conjunto de arquivos de várias semanas, esse é o modo de falha. O modelo termina. O entregável fica mais fino do que o que o GPT-5.6 entregava.
O AutomationBench-AA subiu: Sol 62% contra 60%, Luna 53% contra 50%. Isso é taxa de aprovação de fluxo, não um documento. Não cancela a queda do GDPval.
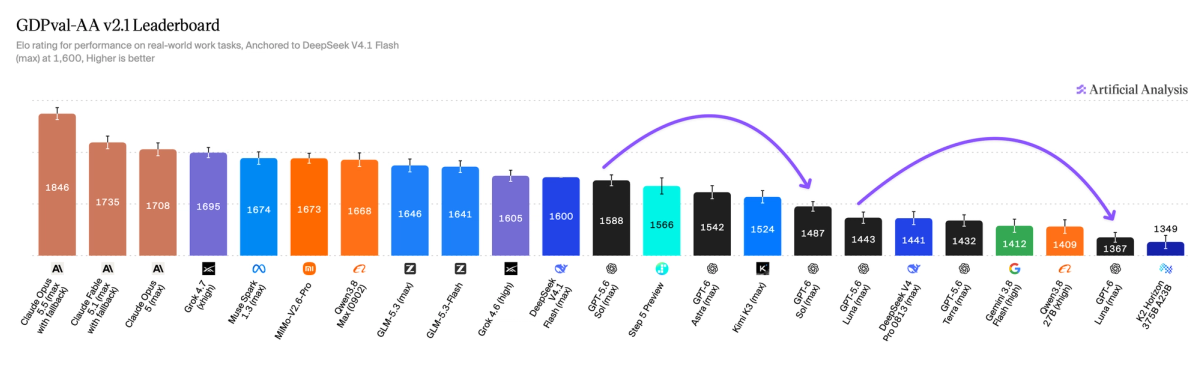
Fonte: Artificial Analysis. O Sol cai cerca de 100 Elo em relação ao GPT-5.6 Sol. A Luna cai cerca de 75. O Opus 5.5 continua em 1846.
Na prática
- Passe o tráfego de GPT-5.6 Sol e Luna para gpt-6-sol e gpt-6-luna quando o trabalho tiver o mesmo formato. O Intelligence Index fica estável. A tabela fica em cerca da metade, e os modelos gastam um pouco mais de tokens, não menos.
- Não aposente o Astra nem o Opus 5.5 porque o Sol no max marca 48. Neste índice o Astra fica em 53 e o Opus 5.5 em 58. O Sol ganhou a fronteira de custo abaixo deles.
- Mantenha briefings, apresentações e arquivos longos de trabalho de conhecimento no modelo que já ganhava o GDPval. O Sol caiu cerca de 100 Elo e a Luna cerca de 75, em entregáveis mais curtos que pulam itens da rubrica.
- Trate a queda de alucinação do Sol como uma política de recusa. A taxa foi de 92% para 60% porque ele tenta 83% das perguntas em vez de 99%. A acurácia caiu de 59% para 54%. Use quando o silêncio for mais barato que uma resposta errada.
- Mantenha as duas cifras de Terminal-Bench separadas. 43% contra 37% é o Sol no Coding Agent Index, no Codex. 44% contra 40% é o Sol na avaliação do Intelligence Index. A nota de código da Luna caiu, 41 contra 43.
- Assuma que a tabela de metade do preço para em 272.000 tokens de entrada. Depois disso, o pedido inteiro fica a 2 vezes na entrada e no cache e a 1,5 vez na saída. O modo rápido é 2 vezes e gasta o desconto.
- Os gráficos do Sol são esforço max. O padrão da API é medium. No Sol, o Chat Completions só faz function-call com o esforço de raciocínio em none. As ferramentas ficam na Responses API.
Fontes: Introducing GPT-6 Sol and Luna, GPT-6 Sol e GPT-6 Luna na API da OpenAI, e Artificial Analysis. Os gráficos e as quedas de Elo são da Artificial Analysis. A tabela de preços é da OpenAI.